

 Español
 English
 Português
 中文 (中国)
 العربية
 हिन्दी
 Français
 Deutsch
 Ελληνικά
 Italiano
 日本語
 한국어
 Latine
Краткое содержание
В этом уроке объясняется, что такое LaTeX и почему им пользуется академическое сообщество. Урок исходит из типографского набора, ремесла размещения каждой буквы, каждой строки и каждой страницы, и из особых требований научных текстов; беспристрастно сравнивает язык разметки и текстовый процессор; рассказывает, почему Дональд Кнут создал TeX и как Лесли Лэмпорт построил на нём LaTeX, принцип которого состоит в отделении содержания от формы; различает три движка, которыми сегодня компилируют документы, pdfLaTeX, XeLaTeX и LuaLaTeX, и обосновывает выбор LuaLaTeX в этом курсе; показывает, как выглядит исходный файл и как он превращается в документ PDF; прослеживает его применение в разных дисциплинах, от математики и физики до философии и филологии; и завершается его границами, чтобы знать, когда достаточно текстового процессора.
Цели обучения
- Объяснять, что такое типографский набор и почему научные тексты требуют его в большей степени, чем другие.
- Сравнивать язык разметки с текстовым процессором, указывая преимущества и издержки каждого из них.
- Отличать TeX от LaTeX и объяснять на примере, что значит отделить содержание от формы.
- Выбирать подходящий движок для документа в зависимости от его языков, систем письма и шрифтов.
- Предсказывать, что даст короткий исходный текст, обращая внимание на пробелы, абзацы и комментарии.
Типографский набор
Любой текст, напечатанный или прочитанный на экране, был набран: кто-то или что-то решил, в какое именно место попадает каждая буква. Типографский набор есть совокупность этих решений: какой шрифт и какой кегль используются, где кончается каждая строка и как распределяется пространство между её словами, чтобы выровнять её по ширине, какие слова переносятся и в каком месте, когда две буквы сливаются в лигатуру, как подгоняется расстояние между определёнными парами букв (кернинг), где обрывается каждая страница, на какой высоте помещаются сноски и как упорядочены заголовки. Веками это было ремеслом наборщика, составлявшего строки из металлических литер; сегодня его выполняет программа, но решения остаются теми же.
Хороший абзац незаметен: глаз скользит по строкам, не спотыкаясь ни о неравные пробелы, ни о нелепые переносы. Однако добиться этого непросто, потому что каждое решение обусловливает последующие: место, где кончается первая строка, определяет, с какого слова начнётся вторая, и так до конца абзаца.
Простой метод заполняет каждую строку столькими словами, сколько в неё помещается, и переходит к следующей, не возвращаясь назад. Если длинное слово не помещается в конце третьей строки, эта строка остаётся с большими пробелами между словами, хотя было бы достаточно перенести одно короткое слово из второй строки, чтобы этого избежать. Метод, который Кнут и Майкл Пласс разработали для TeX, действует иначе: он рассматривает сразу все возможные разрывы абзаца и выбирает сочетание, которое лучше всего распределяет пробелы в целом. Отсюда следует, что строка может остаться чуть менее заполненной, чем допускала, если благодаря этому улучшаются следующие.
Научные тексты требуют такого внимания в большей степени, чем другие. Они содержат формулы, набор которых подчиняется собственным правилам (пробел вокруг знака равенства не тот, что окружает запятую, а нижний индекс уменьшается в определённой пропорции); они постоянно ссылаются сами на себя, с нумерованными разделами, теоремами, рисунками и уравнениями, которые цитируются по номеру; они накапливают сноски и библиографические ссылки, которые должны следовать единому стилю; они часто смешивают несколько языков и несколько систем письма; и обычно они длинны, так что небрежность, повторённая на ста страницах, не исправляется вручную. Если это так, то разумно доверить набор системе, которая решает его по явным правилам и позволяет автору заниматься тем, что он говорит.
Разметка и текстовый процессор
Есть два способа попросить программу набрать текст. В текстовом процессоре, таком как Microsoft Word или LibreOffice Writer, автор видит на экране страницу такой, какой она будет напечатана, и изменяет её непосредственно: выделяет слово и делает его курсивным, перетаскивает поле, выбирает более крупный кегль для заголовка. Этот способ обычно описывают английским выражением what you see is what you get: что видишь, то и получаешь.
В языке разметки, напротив, автор пишет файл простого текста, в который вставляет метки, говорящие, чем является каждая вещь или как с ней следует обращаться: что такое-то слово выделяется, что такая-то строка есть заголовок раздела, что такой-то фрагмент есть цитата. Затем программа читает этот файл и производит свёрстанный документ. Так пишутся веб-страницы, на HTML; LaTeX есть язык разметки, предназначенный для создания качественных печатных документов.
Чтобы сравнение было справедливым, оно должно признать, что каждый способ делает лучше. Текстовый процессор даёт немедленный отклик, почти не требует предварительного обучения, это инструмент, который знает большинство людей, с которыми приходится сотрудничать, а его режим записи исправлений служит обычным средством редактирования во многих издательствах и учреждениях. Язык разметки предлагает, со своей стороны, файлы простого текста, которые любая программа сможет открыть и через сорок лет, которые занимают мало места и версии которых сравниваются построчно; явную структуру, из которой сами собой выводятся оглавления, нумерация и перекрёстные ссылки; единообразие, не зависящее от дисциплинированности автора; и набор формул и абзацев, которого текстовые процессоры не достигают. Его издержки столь же ясны: метки нужно выучить, результат не виден до компиляции, а опечатка может остановить компиляцию.
TeX и LaTeX
Дональд Кнут и TeX
Дональд Кнут, профессор информатики Стэнфордского университета, с 1968 года издавал тома The Art of Computer Programming («Искусство программирования»). Около 1977 года, получив корректуру нового издания второго тома, набранную фотографическим способом, который пришёл на смену металлическим литерам, он счёл её намного хуже первого издания, особенно в формулах. Вместо того чтобы смириться, он решил сам написать программу набора, которая вернула бы математическим книгам качество лучшей традиционной типографики и результат которой был бы одинаков на любом компьютере. Первая версия TeX появилась в 1978 году; в начале следующего десятилетия Кнут полностью переписал её, а также создал программу METAFONT, с помощью которой нарисовал шрифты Computer Modern.
Название происходит из греческого: его буквы суть заглавные тау, эпсилон и хи, начало слова τέχνη, означающего одновременно искусство и мастерство, и потому последняя буква произносится не как «экс», а как «х»: «тех». Кнут объявил TeX завершённым и допускает в нём только исправления ошибок: начиная с версии 3, номер версии приближается к π, и каждое исправление добавляет к нему одну цифру. Эта устойчивость есть одно из его достоинств, ведь документ, написанный десятилетия назад, сегодня компилируется с тем же результатом.
Однако TeX есть язык низкого уровня: его примитивные команды говорят о боксах, растяжимых пробелах и штрафах за разрыв строки в том или ином месте. Для автора, который хочет лишь написать статью, программировать в этих терминах каждый заголовок и каждую сноску было бы несоразмерной нагрузкой. Поэтому TeX позволяет определять макросы, новые команды, которые разворачиваются в другие, более элементарные, и почти всё его реальное использование проходит через коллекции макросов.
Лесли Лэмпорт и LaTeX: содержание отдельно от формы
В начале 1980-х годов Лесли Лэмпорт, специалист по информатике, известный прежде всего работами о распределённых системах, написал поверх TeX коллекцию макросов, которую назвал LaTeX; её первая версия распространилась в 1984 году, а в 1986 году он опубликовал руководство LaTeX: A Document Preparation System. С 1994 года действующую версию, называемую LaTeX2e, поддерживает команда добровольцев, LaTeX Project.
Центральная идея LaTeX состоит в том, что автор размечает содержание, а не форму. Он пишет не «эту строку полужирным и более крупным кеглем», а «это заголовок раздела», с помощью \section{Результаты}; не «это слово курсивом», а «это слово выделяется», с помощью \emph{гипотеза}. Как выглядит заголовок раздела, несёт ли он номер и на каком расстоянии стоит от текста, решает класс документа, объявленный в начале, вместе с командами, которые автор добавляет в преамбулу. Отсюда следует, что вид всего документа меняется в одном месте и что один и тот же текст можно сверстать по правилам двух разных журналов, не трогая ни одной строки тела документа.
В следующем исходном тексте нет никаких указаний на кегль, шрифт или номер: сказано только, чем является каждая строка. Нумерацию раздела и подраздела, кегль и насыщенность их заголовков и курсив выделенного слова определяет класс документа.
\section{Результаты}Данные подтверждают исходную \emph{гипотезу}.\subsection{Выборка}Выборка включает двенадцать текстов трёх авторов.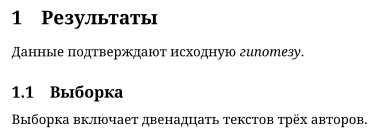
Если позже перед этим разделом вставить другой, его номер сам собой сменится с одного на два, и то же произойдёт с подразделом и со всякой ссылкой на них.
Движки: pdfLaTeX, XeLaTeX и LuaLaTeX
LaTeX есть набор макросов, а не программа: ему нужен движок, программа из семейства TeX, которая исполняет их и производит документ. Сегодня используются три, и все три понимают один и тот же LaTeX; они различаются тем, как читают текст и какими шрифтами могут пользоваться.
- pdfLaTeX использует движок pdfTeX, который Хан Тхе Тхань (Hàn Thế Thành) разработал, чтобы сразу получать файл PDF. Он быстр и очень распространён, и это движок по умолчанию в Overleaf. Однако его шрифты принадлежат классическому формату TeX, не более 256 символов в каждом, так что он не загружает напрямую шрифты, установленные в системе, а писать по-гречески, кириллицей или в других системах письма можно лишь с особыми кодировками и пакетами; без них греческая буква останавливает компиляцию с ошибкой.
- XeLaTeX использует движок XeTeX, созданный Джонатаном Кью, который читает текст в Юникоде, стандарте, присваивающем номер каждому символу всех систем письма, и загружает любой шрифт OpenType из системы с помощью пакета fontspec.
- LuaLaTeX использует движок LuaTeX, который в отношении Юникода и шрифтов предлагает то же, что XeTeX, и вдобавок включает язык программирования Lua, с помощью которого пакеты могут вмешиваться в набор. Современные дистрибутивы запускают его с библиотекой HarfBuzz, которая придаёт форму системам письма, соединяющим или комбинирующим свои буквы, как арабское письмо или деванагари.
В этом курсе используется LuaLaTeX. Причины вытекают из сказанного: он пишет прямо в Юникоде, так что цитата из Платона на политоническом греческом, со всеми ударениями и придыханиями, набирается как есть; он пользуется шрифтами системы, включая те, которые требует университет или журнал; он набирает русский, древнегреческий и латынь в одном документе, каждый со своими правилами переноса; и он допускает, с подходящими пакетами, системы письма, идущие справа налево, как арабская, или не разделяющие слова пробелами, как китайская и японская. Следовательно, одного движка достаточно для всех документов курса, обращённого одновременно к естественным и к гуманитарным наукам. Его единственная издержка по сравнению с pdfLaTeX состоит в несколько более медленной компиляции, которая в документах обычного объёма почти незаметна.
Следующий исходный текст загружает fontspec, выбирает шрифт, в котором есть и кириллица, и греческие буквы, и объявляет с помощью babel русский основным языком, а древнегреческий и латынь дополнительными. Греческие слова пишутся прямо своими символами.
\documentclass{article}\usepackage{fontspec}\usepackage[latin, russian]{babel}\babelprovide[import]{ancientgreek}\setmainfont{Linux Libertine O}\begin{document}Аристотель открывает \emph{Метафизику} такой фразой:\foreignlanguage{ancientgreek}{πάντες ἄνθρωποι τοῦ εἰδέναι ὀρέγονται φύσει.}Латинская традиция передала её так:\foreignlanguage{latin}{omnes homines natura scire desiderant.}\end{document}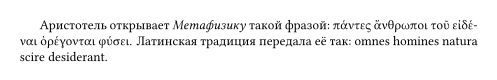
Разметка фрагмента командой \foreignlanguage не меняет вид букв: она указывает, на каком языке написан фрагмент, чтобы к нему применялись его правила переноса и его соглашения. С pdfLaTeX этот же исходный текст не скомпилировался бы: fontspec требует XeLaTeX или LuaLaTeX.
Исходный файл, компиляция и PDF
Документ LaTeX есть файл простого текста с расширением .tex. Он состоит из двух частей. Преамбула тянется от первой строки, \documentclass{article}, которая объявляет класс документа, до \begin{document}; в ней загружаются пакеты, с помощью \usepackage, и принимаются решения о форме. Тело документа тянется от \begin{document} до \end{document} и содержит текст. Команды начинаются с обратной косой черты, а то, что они получают, пишется в фигурных скобках.
Этот исходный текст есть полный документ: он компилируется без каких-либо добавлений и станет отправной точкой для документов курса.
\documentclass{article}\usepackage{fontspec}\usepackage[russian]{babel}\babelfont{rm}{Noto Serif}\begin{document}\section{Введение}Типографский набор решает, куда попадает каждая буква.\end{document}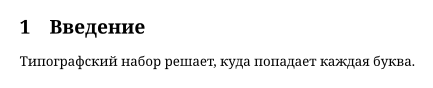
Раздел получает номер один, хотя его никто не писал, а его заголовок использует шрифт и кегль, которые задаёт класс article. Четвёртая строка выбирает шрифт с кириллицей, потому что шрифт LuaLaTeX по умолчанию (Latin Modern) её не содержит.
Рабочий цикл состоит из трёх шагов: пишется исходный текст, он компилируется, и читается результат. Компилировать значит запустить движок на файле, в этом курсе командой lualatex, которая читает исходный текст и записывает файл PDF с тем же именем. Рядом с ним остаются вспомогательные файлы, среди них файл с расширением .log, журнал компиляции, куда движок записывает ошибки и предупреждения, и другой, с расширением .aux, где он хранит номера разделов и страниц. Поэтому оглавление или перекрёстная ссылка появляются правильно только после второй компиляции: при первой движок записывает, где оказалась каждая вещь; при второй пользуется этим. На практике команду не набирают вручную: редактор запускает её нажатием кнопки. В этом курсе работают с Texmaker на собственном компьютере или с Overleaf в браузере; следующий урок готовит эту среду.
Исходный текст набирается не так, как написан, и три правила объясняют почти все неожиданности начала. Во-первых, несколько пробелов подряд равны одному, а перевод строки равен пробелу: движок сам распределяет пространство, и пробел, который пишет автор, лишь указывает, что здесь кончается слово. Во-вторых, одна или несколько пустых строк завершают абзац и начинают новый. В-третьих, знак % начинает комментарий: движок пропускает всё, что следует за ним до конца строки, включая сам перевод строки.
Следующий исходный текст нарочно написан небрежно. В результате получаются два абзаца с равномерными пробелами, а заметка после знака комментария не появляется.
Повторённые пробелы сводятся к одному, и этот перевод строкитоже пробел.Пустая строка открывает новый абзац. % Эта заметка не печатается.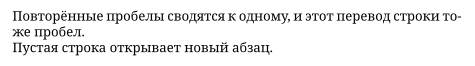
Если это так, то, чтобы напечатать знак процента, недостаточно его написать: перед ним нужно поставить обратную косую черту, вот так: \%. То же относится к другим символам, которые LaTeX резервирует для собственных нужд, например к фигурным скобкам или знаку доллара.
LaTeX в академических дисциплинах
В математике, физике и значительной части информатики LaTeX является нормой: журналы предлагают собственные классы документов, чтобы авторы подавали статьи в их формате, а arXiv, хранилище, где статьи этих дисциплин распространяются до публикации, принимает исходные тексты LaTeX и сам их компилирует. Причина в наборе формул, с которым ни одна другая система не справляется так же хорошо при столь малых усилиях, и в автоматической нумерации теорем и уравнений. Экономика, статистика, инженерные науки и химия также широко им пользуются.
Было бы, однако, ошибкой считать LaTeX делом исключительно точных наук. В философии, классической филологии и истории его достоинства иные, но не меньшие. Для критических изданий, которые сопровождают древний текст аппаратом, фиксирующим разночтения рукописей в примечаниях с привязкой к номерам строк, в LaTeX есть специализированные пакеты, например reledmac, которые нумеруют строки, упорядочивают несколько уровней примечаний и сохраняют их ссылки при изменении текста. Политонический греческий и латынь пишутся и переносятся правильно, как мы видели. Сноски, которых в гуманитарном исследовании могут быть сотни, сами нумеруются и размещаются на своей странице. А библиография с BibLaTeX пишется один раз в виде базы данных и цитируется в любом требуемом стиле, будь то стиль «автор и год» общественных наук, числовой стиль естественных наук или стиль подстрочных сносок гуманитарных наук, изменением одного параметра.
Границы LaTeX
Однако у LaTeX есть реальные издержки, и их стоит знать, прежде чем его принимать. Кривая обучения крутая: в первые недели приходится часто выяснять, как сделать то, что в текстовом процессоре делается одним щелчком. Его сообщения об ошибках, унаследованные от TeX, часто загадочны и иногда указывают на строку, следующую за той, что содержит ошибку; один из ближайших уроков этого раздела учит их читать. Вёрстка страниц свободного дизайна, таких как плакат или иллюстрированный журнал, где каждый элемент размещается вручную, оказывается трудоёмче, чем в программе вёрстки. И не все адресаты его принимают: немало гуманитарных журналов, издательств и учреждений требуют файл текстового процессора и редактируют в режиме записи исправлений.
Откуда следует простой критерий. Короткое письмо, протокол, бланк или текст, который другой человек будет редактировать в текстовом процессоре, лучше писать в текстовом процессоре. Длинный документ со структурой, формулами, цитатами, примечаниями, несколькими языками или долгой жизнью впереди, который придётся годами исправлять и переиздавать, лучше писать в LaTeX.
Решённые задачи
Следующие задачи требуют не вспомнить сказанное, а применить его: первая требует точно предсказать, что даёт исходный текст, вторая решить, какой движок и какие шрифты нужны документу, а третья отделить содержание от формы в исходном тексте, написанном без такой заботы.
Не компилируя, точно предсказать текст, который даёт следующее тело документа, сколько в нём абзацев и что происходит с каждым знаком процента.
Типографский набор решает, куда попадает каждая буква.Хороший абзац незаметен.Около 50 % читателейне замечают разницы. Это сло%во остаётся целым.Решение
Между первыми тремя строками нет ни одной пустой строки: они образуют один абзац. Повторённые пробелы и пробелы в начале второй строки сводятся к одному, а каждый перевод строки равен пробелу. Первый абзац гласит: «Типографский набор решает, куда попадает каждая буква. Хороший абзац незаметен.»
Далее идут две пустые строки. Одной достаточно, чтобы завершить абзац, а вторая ничего не добавляет: нет ни пустого абзаца, ни увеличенного промежутка. Следовательно, начинается второй абзац.
В строке
Около 50 % читателейзнак процента не печатается: он начинает комментарий. Движок отбрасывает «читателей» и также перевод строки; остаётся только пробел, написанный перед знаком, и следующая строка продолжается от него.В «сло» знак процента приклеен к слову: он отбрасывает перевод строки, не оставляя никакого пробела, а движок пропускает пробелы в начале следующей строки. Отсюда следует, что «сло» и «во» сливаются в одно слово.
Второй абзац гласит: «Около 50 не замечают разницы. Это слово остаётся целым.» Автор хотел написать процент и потерял полфразы, причём движок не сообщил ни о какой ошибке; чтобы напечатать знак, нужно было написать
\%.
Студентка философского факультета пишет по-русски диссертацию о «Федоне». Она цитирует места из Платона на политоническом греческом и места из латинских комментаторов, а её университет требует определённый шрифт, установленный на её компьютере как файл OpenType, в котором есть кириллица, но нет греческих букв. Решить, какой движок ей нужен и что ещё она должна объявить, чтобы документ вышел полным.
Решение
pdfLaTeX отпадает по двум независимым причинам: он не загружает напрямую шрифты OpenType из системы, а греческая буква, написанная в Юникоде, останавливает его компиляцию, если не подготовить особые кодировки и шрифты. Первой причины достаточно, чтобы его исключить, поскольку институциональный шрифт обязателен.
XeLaTeX и LuaLaTeX читают Юникод и загружают шрифты системы с помощью fontspec: с любым из них институциональный шрифт объявляется в преамбуле командой
\setmainfont. В курсе используется LuaLaTeX.Однако одного движка недостаточно. Если в шрифте нет греческих букв, LuaLaTeX компилирует без ошибок, но греческие слова не появляются в PDF: движок лишь отмечает это в журнале компиляции предупреждениями вида
Missing character. Проблема видна не при компиляции, а при чтении результата.Следовательно, греческому нужно назначить второй шрифт, который его содержит. С помощью babel древнегреческий объявляется языком командой
\babelprovide[import]{ancientgreek}, а шрифт ему назначается командой\babelfont[ancientgreek]{rm}{GFS Didot}; каждый греческий фрагмент размечается командой\foreignlanguage.Латынь пишется латинским алфавитом, который в институциональном шрифте есть; ей нужен не другой шрифт, а лишь объявление как языка, опцией
latinпакета babel, чтобы её слова переносились по правилам латыни, а не русского языка.Итак: LuaLaTeX, институциональный шрифт как основной, шрифт с политоническим греческим для греческих фрагментов, и русский, древнегреческий и латынь, объявленные как языки.
Автор написал так начало второго раздела статьи. Указать, какие метки выражают форму вместо содержания, переписать их так, чтобы они говорили лишь, чем является каждая вещь, и объяснить, что выигрывается, если журнал потом попросит, чтобы греческие термины шли без курсива.
{\Large\bfseries 2. Результаты}\\[6pt]Как утверждает Аристотель в \textit{Метафизике}, стремлениек знанию \textit{естественно}; греческий термин \textit{φύσει}.\\\vspace{12pt}{\large\bfseries 2.1. Выборка}\\Решение
Первая строка вручную задаёт кегль, насыщенность, номер и отступ того, что на самом деле является заголовком раздела. Она заменяется на
\section{Результаты}, а номер ставит класс; написанный вручную, он разошёлся бы с действительностью, как только был бы вставлен предшествующий раздел.В этом исходном тексте
\textitвстречается трижды, с тремя разными функциями: отмечает название произведения, выделенное слово и греческий термин. То, что все три сегодня печатаются курсивом, есть совпадение формы, а не тождество содержания.Каждая функция получает собственную метку. Для выделенного слова существует
\emph{естественно}; для двух других в преамбуле определяются новые команды, например\newcommand{\proizv}[1]{\textit{#1}}и аналогичная ей\termin, которые в теле документа используются как\proizv{Метафизике}и\termin{φύσει}.Двойные обратные косые черты, вызывающие принудительный перевод строки, и добавленный вручную вертикальный отступ подражают разделению абзацев. Они удаляются: пустая строка завершает абзац, а отступ определяет класс. Заголовок подраздела пишется
\subsection{Выборка}.Если журнал попросит греческие термины без курсива, достаточно изменить одну строку преамбулы, ту, что определяет
\termin, и изменение затронет все термины статьи, не касаясь названий произведений и выделенных слов. В исходном варианте пришлось бы просматривать все курсивы по одному и в каждом случае решать, какой функции он соответствовал.
Упражнения онлайн
В этих упражнениях код пишется в поле, и браузер сразу его проверяет: контролирует фигурные скобки, окружения и то, что требует каждое упражнение, не компилируя код. Когда проверка пройдена, стоит скопировать код в Texmaker и скомпилировать его, потому что только скомпилированный результат показывает, что на самом деле печатается.
В поле находится только текст документа, написанного по-испански; проверка ищет именно этот текст, поэтому его нужно оставить как есть. Дополнить его до целого документа, который компилируется LuaLaTeX: класс article, пакеты fontspec и babel с испанским, языком текста, а также начало и конец тела документа. Испанский пишется латиницей, поэтому другой шрифт не нужен. Текст не меняется.
Браузер сразу проверяет твой код, не компилируя и не оценивая его. Чтобы увидеть настоящий результат, скомпилируй его в Texmaker.
Подсказка
Документ состоит из двух частей: преамбулы, которая начинается с класса и загружает пакеты, и тела, которое содержит текст.
Показать решение
\documentclass{article}\usepackage{fontspec}\usepackage[spanish]{babel}\begin{document}\section{Introducción}La composición tipográfica decide dónde cae cada letra.\end{document}Следующий фрагмент, взятый из испанской статьи, говорит, как должна выглядеть каждая строка, а не чем она является. Переписать его так, чтобы он размечал содержание: первый заголовок есть раздел, второй подраздел, оба нумеруются классом, а «qué es» («что есть») есть выделенное выражение. Текст не меняется (проверка ищет испанские слова), а принудительные переводы строки исчезают.
Браузер сразу проверяет твой код, не компилируя и не оценивая его. Чтобы увидеть настоящий результат, скомпилируй его в Texmaker.
Подсказка
Для каждой строки спроси себя, чем она является (заголовком раздела, подраздела, выделенным выражением), и найди команду, которая это говорит; всё остальное определяет класс.
Показать решение
\section{Marcado y procesador de textos}En un lenguaje de marcado, el autor dice \emph{qué es} cada cosa.\subsection{El procesador de textos}El autor ve la página tal como se imprimirá.Задачи для самостоятельного решения
К каждой задаче есть подсказка, которую лучше открывать только после собственной попытки, и ответ, который появляется после того, как открыта подсказка.
Предсказать, какой текст даёт следующее тело документа, в котором \LaTeX и \TeX суть команды, печатающие логотипы LaTeX и TeX. Объяснить разницу между двумя строками и предложить исправление для первой.
Я пишу в \LaTeX уже год.Я пользуюсь \LaTeX{} и \TeX\ каждый день.Подсказка
Спроси себя, где кончается имя команды, состоящее из букв, и что движок делает с пробелом, который следует за ним: относится ли он к тексту или к команде?
Ответ
Один абзац: «Я пишу в LaTeXуже год. Я пользуюсь LaTeX и TeX каждый день.» Имя команды кончается на первом символе, который не является буквой, а следующие за ним пробелы поглощаются при его чтении; во второй строке пустые фигурные скобки и обратная косая черта с пробелом закрывают команду и сохраняют пробел. Первая строка исправляется так: \LaTeX{} уже или обратной косой чертой с пробелом. Заметим, что в LuaLaTeX буквами считаются и кириллические, так что \LaTeXуже без пробела было бы именем другой, несуществующей команды.
Для каждого из следующих документов решить, какими движками его можно скомпилировать без особой подготовки, и обосновать решение: диссертация по математике на английском, набранная шрифтом LaTeX по умолчанию; издание греческого трактата с примечаниями на латыни, которое должно использовать шрифт OpenType, установленный в системе; и статья на русском, цитирующая источники на арабском и на хинди. Затем объяснить, почему курс принимает один движок для всех.
Подсказка
Для каждого документа спроси себя о двух вещах: нужен ли ему шрифт системы и содержит ли он системы письма, отличные от латинского алфавита, которые должны читаться в Юникоде и в некоторых случаях соединять или комбинировать свои буквы.
Ответ
Диссертация по математике допускает все три движка. Греческое издание требует XeLaTeX или LuaLaTeX из-за шрифта системы и из-за греческого в Юникоде. Статья с арабским и хинди тоже требует XeLaTeX или LuaLaTeX из-за Юникода, из-за букв, которые соединяются и комбинируются, а в арабском и из-за письма справа налево; к тому же сама кириллица без особых пакетов в pdfLaTeX не набирается. LuaLaTeX подходит для всех трёх, и с одним движком все исходные тексты курса компилируются одинаково.
Решить для каждого случая, что предпочтительнее, LaTeX или текстовый процессор, и обосновать решение критерием, отличным от привычки: письмо на две страницы, адресованное в учреждение; диссертация на двести страниц с формулами, нумерованными рисунками и ста пятьюдесятью ссылками; статья для исторического журнала, который принимает только файлы текстового процессора и редактирует в режиме записи исправлений; и конспект лекций с греческими цитатами, который его автор будет дополнять несколько лет.
Подсказка
Учти в каждом случае объём и структуру документа, как долго он будет жить и кто ещё должен будет читать или изменять его файл, а не только напечатанный результат.
Ответ
Письмо в текстовом процессоре: оно короткое, без структуры и без дальнейшей жизни. Диссертация в LaTeX: её объём, формулы и ссылки выигрывают от автоматической нумерации и от библиографии в виде базы данных. Статья в текстовом процессоре, потому что этого требует адресат. Конспект в LaTeX: его долгая жизнь, растущая структура и греческий говорят в пользу простого текста и Юникода.