

 Español
 English
 Português
 中文 (中国)
 العربية
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 日本語
 한국어
 Latine
सारांश
यह पाठ बताता है कि LaTeX क्या है और अकादमिक जगत उसका उपयोग क्यों करता है। यह टाइपसेटिंग से आरंभ करता है, यानी हर अक्षर, हर पंक्ति और हर पृष्ठ को सजाने की कला से, और अकादमिक पाठों की विशेष माँगों से; मार्कअप भाषा और वर्ड प्रोसेसर की निष्पक्ष तुलना करता है; बताता है कि डोनाल्ड क्नूथ (Donald Knuth) ने TeX क्यों बनाया और लेस्ली लैम्पोर्ट (Leslie Lamport) ने उस पर LaTeX कैसे खड़ा किया, जिसका सिद्धांत विषय-वस्तु को रूप से अलग करना है; आज कंपाइल करने वाले तीन इंजनों, pdfLaTeX, XeLaTeX और LuaLaTeX, में भेद करता है और इस पाठ्यक्रम में LuaLaTeX के चुनाव का औचित्य बताता है; दिखाता है कि स्रोत फ़ाइल कैसी दिखती है और वह PDF दस्तावेज़ में कैसे बदलती है; गणित और भौतिकी से लेकर दर्शन और भाषाशास्त्र तक, विभिन्न विषयों में उसके उपयोग का सर्वेक्षण करता है; और उसकी सीमाओं के साथ समाप्त होता है, ताकि पता रहे कि कब वर्ड प्रोसेसर पर्याप्त है।
अधिगम उद्देश्य
- समझाना कि टाइपसेटिंग क्या है और अकादमिक पाठ उसकी माँग दूसरों की अपेक्षा अधिक क्यों करते हैं।
- मार्कअप भाषा और वर्ड प्रोसेसर की तुलना करना, दोनों के लाभ और लागत बताते हुए।
- TeX और LaTeX में भेद करना और एक उदाहरण से समझाना कि विषय-वस्तु को रूप से अलग करने का क्या अर्थ है।
- किसी दस्तावेज़ के लिए उसकी भाषाओं, लिपियों और फ़ॉन्टों के अनुसार उपयुक्त इंजन चुनना।
- रिक्त स्थानों, अनुच्छेदों और टिप्पणियों पर ध्यान देते हुए अनुमान लगाना कि एक छोटा स्रोत क्या उत्पन्न करता है।
टाइपसेटिंग
छपा हुआ या स्क्रीन पर पढ़ा जाने वाला हर पाठ टाइपसेट किया गया है: किसी व्यक्ति ने, या किसी चीज़ ने, तय किया है कि हर अक्षर ठीक किस स्थान पर पड़ेगा। टाइपसेटिंग इन्हीं निर्णयों का समूह है: कौन-सा फ़ॉन्ट और कौन-सा आकार प्रयोग होगा, हर पंक्ति कहाँ समाप्त होगी और उसे दोनों ओर बराबर करने के लिए उसके शब्दों के बीच जगह कैसे बाँटी जाएगी, किन शब्दों को पंक्ति के अंत में हाइफ़न से तोड़ा जाएगा और कहाँ से, कब दो अक्षर मिलकर संयुक्ताक्षर बनेंगे, अक्षरों के कुछ जोड़ों के बीच की दूरी कैसे समायोजित होगी, हर पृष्ठ कहाँ टूटेगा, पाद-टिप्पणियाँ किस ऊँचाई पर जाएँगी और शीर्षक किस क्रम में होंगे। सदियों तक यह कंपोज़िटर का काम था, जो धातु के टाइपों से पंक्तियाँ बनाता था; आज इसे एक प्रोग्राम करता है, पर निर्णय वही रहते हैं।
अच्छा अनुच्छेद ध्यान नहीं खींचता: आँख असमान रिक्तियों या बेतुके विभाजनों पर अटके बिना पंक्तियों पर चलती जाती है। परंतु यह साधना सरल नहीं है, क्योंकि हर निर्णय आगे के निर्णयों को प्रभावित करता है: पहली पंक्ति जहाँ समाप्त होती है, वही तय करता है कि दूसरी किस शब्द से शुरू होगी, और यही क्रम अनुच्छेद के अंत तक चलता है।
एक सरल विधि हर पंक्ति में जितने शब्द समा सकें उतने भरती है और पीछे लौटे बिना अगली पंक्ति पर चली जाती है। यदि तीसरी पंक्ति के अंत में कोई लंबा शब्द नहीं समाता, तो उस पंक्ति के शब्दों के बीच बड़ी-बड़ी रिक्तियाँ रह जाती हैं, जबकि दूसरी पंक्ति से एक छोटा शब्द खिसका देना ही इससे बचने के लिए काफ़ी होता। क्नूथ और माइकल प्लास (Michael Plass) ने TeX के लिए जो विधि बनाई, वह अलग ढंग से काम करती है: वह अनुच्छेद के सभी संभव पंक्ति-विरामों पर एक साथ विचार करती है और वह संयोजन चुनती है जो पूरे अनुच्छेद में रिक्तियों को सबसे अच्छी तरह बाँटता है। इससे यह निकलता है कि कोई पंक्ति जितनी भर सकती थी उससे थोड़ी कम भरी रह सकती है, यदि इससे आगे की पंक्तियाँ बेहतर हो जाएँ।
अकादमिक पाठ इस सावधानी की माँग दूसरों की अपेक्षा अधिक करते हैं। उनमें सूत्र होते हैं, जिनकी टाइपसेटिंग के अपने नियम हैं (बराबर के चिह्न के आसपास की जगह वह नहीं होती जो अल्पविराम के आसपास होती है, और पादांक एक निश्चित अनुपात में छोटा होता है); वे बार-बार स्वयं का संदर्भ देते हैं, क्रमांकित खंडों, प्रमेयों, चित्रों और समीकरणों के साथ, जिनका उल्लेख उनकी संख्या से होता है; उनमें पाद-टिप्पणियाँ और ग्रंथसूची-संदर्भ जमा होते हैं, जिन्हें एक समान शैली का पालन करना होता है; वे प्रायः कई भाषाओं और कई लिपियों को मिलाते हैं; और वे सामान्यतः लंबे होते हैं, इसलिए सौ पृष्ठों में दोहराई गई कोई चूक हाथ से नहीं सुधारी जा सकती। यदि ऐसा है, तो टाइपसेटिंग किसी ऐसी प्रणाली को सौंपना उचित है जो उसे स्पष्ट नियमों से हल करे और लेखक को इस पर ध्यान देने दे कि वह क्या कह रहा है।
मार्कअप और वर्ड प्रोसेसर
किसी प्रोग्राम से पाठ टाइपसेट करवाने के दो तरीके हैं। वर्ड प्रोसेसर में, जैसे Microsoft Word या LibreOffice Writer, लेखक स्क्रीन पर पृष्ठ को वैसा ही देखता है जैसा वह छपेगा, और उसे सीधे बदलता है: किसी शब्द को चुनकर तिरछा करता है, हाशिया खींचता है, किसी शीर्षक के लिए बड़ा आकार चुनता है। इस तरीके का वर्णन प्रायः अंग्रेज़ी वाक्यांश what you see is what you get से किया जाता है: जो दिखता है, वही मिलता है।
इसके विपरीत, मार्कअप भाषा में लेखक एक सादी टेक्स्ट फ़ाइल लिखता है, जिसमें वह ऐसे चिह्न डालता है जो बताते हैं कि हर चीज़ क्या है या उसके साथ कैसा व्यवहार हो: कि अमुक शब्द पर ज़ोर है, कि अमुक पंक्ति किसी खंड का शीर्षक है, कि अमुक अंश उद्धरण है। फिर एक प्रोग्राम उस फ़ाइल को पढ़ता है और टाइपसेट किया हुआ दस्तावेज़ बनाता है। वेब पृष्ठ इसी तरह HTML में लिखे जाते हैं; LaTeX एक मार्कअप भाषा है जो उच्च गुणवत्ता के मुद्रित दस्तावेज़ बनाने के लिए रची गई है।
तुलना न्यायसंगत हो, इसके लिए उसे मानना होगा कि हर तरीका क्या बेहतर करता है। वर्ड प्रोसेसर तुरंत प्रतिक्रिया देता है, लगभग किसी पूर्व-शिक्षा की माँग नहीं करता, वह औज़ार है जिसे सहयोग करने वाले अधिकतर लोग जानते हैं, और उसकी परिवर्तन-ट्रैकिंग सुविधा कई प्रकाशन-गृहों और कार्यालयों में संशोधन का सामान्य साधन है। मार्कअप भाषा अपनी ओर से देती है: सादी टेक्स्ट फ़ाइलें, जिन्हें कोई भी प्रोग्राम चालीस वर्ष बाद भी खोल सकेगा, जो कम जगह लेती हैं और जिनके संस्करणों की पंक्ति-दर-पंक्ति तुलना होती है; एक स्पष्ट संरचना, जिससे विषय-सूचियाँ, क्रमांकन और परस्पर-संदर्भ अपने आप निकलते हैं; एक एकरूपता, जो लेखक के अनुशासन पर निर्भर नहीं करती; और सूत्रों तथा अनुच्छेदों की ऐसी टाइपसेटिंग, जहाँ तक वर्ड प्रोसेसर नहीं पहुँचते। उसकी लागत भी उतनी ही स्पष्ट है: चिह्न सीखने पड़ते हैं, परिणाम कंपाइल करने से पहले नहीं दिखता, और टाइप की एक भूल कंपाइलेशन रोक सकती है।
TeX और LaTeX
डोनाल्ड क्नूथ और TeX
स्टैनफ़र्ड विश्वविद्यालय में कंप्यूटर विज्ञान के प्रोफ़ेसर डोनाल्ड क्नूथ 1968 से The Art of Computer Programming के खंड प्रकाशित कर रहे थे। लगभग 1977 में, जब उन्हें दूसरे खंड के नए संस्करण के प्रूफ़ मिले, जो उस फ़ोटोग्राफ़िक तकनीक से टाइपसेट थे जिसने धातु के टाइपों की जगह ले ली थी, तो उन्होंने उन्हें पहले संस्करण की तुलना में बहुत घटिया पाया, ख़ासकर सूत्रों में। हार मानने के बजाय उन्होंने स्वयं एक टाइपसेटिंग प्रोग्राम लिखने का निश्चय किया, जो गणित की पुस्तकों को सर्वोत्तम पारंपरिक टाइपोग्राफ़ी की गुणवत्ता लौटा दे और जिसका परिणाम किसी भी कंप्यूटर पर एक जैसा हो। TeX का पहला संस्करण 1978 में आया; अगले दशक के आरंभ में क्नूथ ने उसे पूरी तरह फिर से लिखा और METAFONT प्रोग्राम भी बनाया, जिससे उन्होंने Computer Modern फ़ॉन्ट रचे।
यह नाम यूनानी से आया है: इसके अक्षर बड़े ताउ, एप्सिलॉन और ख़ी हैं, शब्द τέχνη का आरंभ, जिसका अर्थ एक साथ कला और तकनीक है, और इसीलिए अंतिम अक्षर का उच्चारण x जैसा नहीं, बल्कि लगभग “ख़” जैसा होता है: “टेख़”। क्नूथ ने TeX को पूर्ण घोषित कर दिया है और उसमें केवल त्रुटि-सुधार स्वीकार करते हैं: संस्करण 3 से संस्करण-संख्या π के निकट जाती है, और हर सुधार उसमें एक अंक जोड़ देता है। यह स्थिरता उसके गुणों में से एक है, क्योंकि दशकों पहले लिखा गया दस्तावेज़ आज भी उसी परिणाम के साथ कंपाइल होता है।
परंतु TeX निम्न-स्तरीय भाषा है: उसके मूल कमांड बक्सों, लचीली रिक्तियों और किसी पंक्ति को इस या उस स्थान पर तोड़ने के दंडों की बात करते हैं। जो लेखक केवल एक लेख लिखना चाहता है, उसके लिए हर शीर्षक और हर टिप्पणी को इन शब्दों में प्रोग्राम करना असंगत बोझ होता। इसलिए TeX मैक्रो परिभाषित करने देता है, यानी ऐसे नए कमांड जो अधिक प्राथमिक कमांडों में खुल जाते हैं, और उसका लगभग सारा वास्तविक उपयोग मैक्रो-संग्रहों से होकर गुज़रता है।
लेस्ली लैम्पोर्ट और LaTeX: विषय-वस्तु रूप से अलग
1980 के दशक के आरंभ में लेस्ली लैम्पोर्ट ने, जो वितरित प्रणालियों पर अपने काम के लिए सबसे अधिक जाने जाने वाले कंप्यूटर वैज्ञानिक हैं, TeX के ऊपर मैक्रो का एक संग्रह लिखा, जिसे उन्होंने LaTeX नाम दिया और जिसका पहला संस्करण 1984 में प्रचलन में आया; 1986 में उन्होंने LaTeX: A Document Preparation System नामक पुस्तिका प्रकाशित की। 1994 से वर्तमान संस्करण, जिसे LaTeX2e कहते हैं, स्वयंसेवकों की एक टीम, LaTeX Project, सँभालती है।
LaTeX का केंद्रीय विचार यह है कि लेखक विषय-वस्तु को चिह्नित करे, रूप को नहीं। वह यह नहीं लिखता कि “यह पंक्ति मोटे अक्षरों में और बड़े आकार में”, बल्कि यह कि “यह एक खंड का शीर्षक है”, \section{परिणाम} से; वह यह नहीं लिखता कि “यह शब्द तिरछे अक्षरों में”, बल्कि यह कि “इस शब्द पर ज़ोर है”, \emph{परिकल्पना} से। खंड-शीर्षक कैसा दिखेगा, उस पर संख्या होगी या नहीं, और वह पाठ से कितनी दूरी पर रहेगा, यह दस्तावेज़ की क्लास तय करती है, जो आरंभ में घोषित होती है, साथ में वे कमांड जो लेखक प्रस्तावना में जोड़ता है। इससे यह निकलता है कि पूरे दस्तावेज़ का रूप एक ही स्थान पर बदला जाता है, और एक ही पाठ को मुख्य भाग की एक भी पंक्ति छुए बिना दो अलग पत्रिकाओं के नियमों के अनुसार टाइपसेट किया जा सकता है।
नीचे के स्रोत में आकार, फ़ॉन्ट या संख्या का कोई संकेत नहीं है: केवल यह कहा गया है कि हर पंक्ति क्या है। खंड और उपखंड का क्रमांकन, उनके शीर्षकों का आकार और मोटाई, और ज़ोर वाले शब्द का रूप दस्तावेज़ की क्लास तय करती है। लैटिन लिपि में ज़ोर सामान्यतः तिरछे अक्षरों से दिखाया जाता है; देवनागरी फ़ॉन्टों में प्रायः तिरछे अक्षर नहीं होते, इसलिए यहाँ वह शब्द बदला हुआ नहीं दिखता, और हिंदी दस्तावेज़ों में ज़ोर का रूप प्रस्तावना में अलग से तय किया जाता है।
\section{परिणाम}आँकड़े आरंभिक \emph{परिकल्पना} की पुष्टि करते हैं।\subsection{नमूना}नमूने में तीन लेखकों के बारह पाठ शामिल हैं।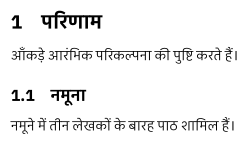
यदि बाद में इस खंड से पहले कोई खंड जोड़ा जाए, तो इसकी संख्या अपने आप एक से दो हो जाती है, और यही उपखंड के साथ तथा उनका उल्लेख करने वाले हर संदर्भ के साथ होता है।
इंजन: pdfLaTeX, XeLaTeX और LuaLaTeX
LaTeX मैक्रो का एक समूह है, कोई प्रोग्राम नहीं: उसे एक इंजन चाहिए, TeX परिवार का एक प्रोग्राम जो उन्हें चलाए और दस्तावेज़ बनाए। आज तीन इंजन प्रयोग में हैं, और तीनों एक ही LaTeX समझते हैं; वे इस बात में भिन्न हैं कि पाठ को कैसे पढ़ते हैं और कौन-से फ़ॉन्ट उपयोग कर सकते हैं।
- pdfLaTeX pdfTeX इंजन का उपयोग करता है, जिसे हान थे थान (Hàn Thế Thành) ने सीधे PDF फ़ाइल बनाने के लिए विकसित किया। यह तेज़ और बहुत प्रचलित है, और Overleaf का डिफ़ॉल्ट इंजन है। परंतु इसके फ़ॉन्ट TeX के क्लासिक फ़ॉर्मेट के हैं, जिनमें से हर एक में अधिकतम 256 वर्ण होते हैं, इसलिए यह सिस्टम में स्थापित फ़ॉन्टों को सीधे लोड नहीं करता, और यूनानी, सिरिलिक, देवनागरी या दूसरी लिपियाँ लिखने के लिए विशेष एन्कोडिंग और पैकेज चाहिए; उनके बिना एक यूनानी अक्षर त्रुटि के साथ कंपाइलेशन रोक देता है।
- XeLaTeX XeTeX इंजन का उपयोग करता है, जिसे जोनाथन क्यू (Jonathan Kew) ने बनाया; यह पाठ को Unicode में पढ़ता है, वह मानक जो सभी लिपियों के हर वर्ण को एक संख्या देता है, और fontspec पैकेज के माध्यम से सिस्टम का कोई भी OpenType फ़ॉन्ट लोड करता है।
- LuaLaTeX LuaTeX इंजन का उपयोग करता है, जो Unicode और फ़ॉन्टों के मामले में वही देता है जो XeTeX देता है, और इसके अतिरिक्त Lua प्रोग्रामिंग भाषा समाहित करता है, जिसके द्वारा पैकेज टाइपसेटिंग में हस्तक्षेप कर सकते हैं। वर्तमान वितरण इसे HarfBuzz लाइब्रेरी के साथ चलाते हैं, जो उन लिपियों को आकार देती है जिनके अक्षर जुड़ते या संयुक्त होते हैं, जैसे अरबी या देवनागरी।
यह पाठ्यक्रम LuaLaTeX का उपयोग करता है। कारण ऊपर कही बातों से निकलते हैं: यह सीधे Unicode में लिखता है, इसलिए प्लेटो का बहुस्वरी यूनानी में कोई उद्धरण, अपने स्वराघातों और श्वास-चिह्नों सहित, जैसा है वैसा टाइप होता है, और देवनागरी के संयुक्ताक्षर और मात्राएँ भी; यह सिस्टम के फ़ॉन्टों का उपयोग करता है, उन फ़ॉन्टों सहित जिनकी माँग कोई विश्वविद्यालय या पत्रिका करे; यह हिंदी, यूनानी और लैटिन को एक ही दस्तावेज़ में टाइपसेट करता है, हर एक को उसके अपने नियमों के साथ; और उपयुक्त पैकेजों के साथ यह उन लिपियों को स्वीकार करता है जो दाएँ से बाएँ चलती हैं, जैसे अरबी, या जो अपने शब्दों को रिक्त स्थानों से अलग नहीं करतीं, जैसे चीनी और जापानी। अतः विज्ञानों और मानविकी दोनों को एक साथ संबोधित पाठ्यक्रम के सभी दस्तावेज़ों के लिए एक ही इंजन पर्याप्त है। pdfLaTeX की तुलना में इसकी एकमात्र लागत थोड़ा धीमा कंपाइलेशन है, जो सामान्य आकार के दस्तावेज़ों में मुश्किल से महसूस होता है।
नीचे का स्रोत fontspec लोड करता है और babel के द्वारा हिंदी को मुख्य भाषा घोषित करता है, जिसके लिए एक देवनागरी फ़ॉन्ट चुना गया है, तथा प्राचीन यूनानी और लैटिन को गौण भाषाएँ, जिन्हें एक ऐसा फ़ॉन्ट दिया गया है जिसमें यूनानी अक्षर हैं, क्योंकि देवनागरी फ़ॉन्ट में वे नहीं हैं। यूनानी शब्द सीधे अपने वर्णों से लिखे जाते हैं।
\documentclass{article}\usepackage{fontspec}\usepackage{babel}\babelprovide[import,main]{hindi}\babelprovide[import]{ancientgreek}\babelprovide[import]{latin}\babelfont{rm}[Script=Devanagari]{IBM Plex Sans Devanagari}\babelfont[ancientgreek,latin]{rm}{Linux Libertine O}\begin{document}अरस्तू अपनी कृति “तत्त्वमीमांसा” का आरंभ इस वाक्य से करते हैं:\foreignlanguage{ancientgreek}{πάντες ἄνθρωποι τοῦ εἰδέναι ὀρέγονται φύσει.}लैटिन परंपरा ने इसे इस रूप में आगे पहुँचाया:\foreignlanguage{latin}{omnes homines natura scire desiderant.}\end{document}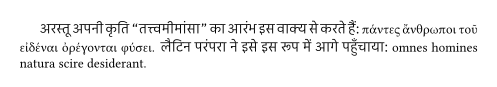
किसी अंश को \foreignlanguage से चिह्नित करना यह बताता है कि अंश किस भाषा में है, ताकि उस पर उसी भाषा के शब्द-विभाजन के नियम और परिपाटियाँ लागू हों; यहाँ यह उसका फ़ॉन्ट भी चुनता है, क्योंकि \babelfont ने हर भाषा को उसका फ़ॉन्ट सौंपा है। pdfLaTeX से यही स्रोत कंपाइल नहीं होता: fontspec को XeLaTeX या LuaLaTeX चाहिए।
स्रोत फ़ाइल, कंपाइलेशन और PDF
LaTeX दस्तावेज़ .tex एक्सटेंशन वाली एक सादी टेक्स्ट फ़ाइल है। इसके दो भाग होते हैं। प्रस्तावना पहली पंक्ति, \documentclass{article}, से, जो दस्तावेज़ की क्लास घोषित करती है, \begin{document} तक जाती है; इसमें \usepackage से पैकेज लोड किए जाते हैं और रूप-संबंधी निर्णय तय किए जाते हैं। मुख्य भाग \begin{document} से \end{document} तक जाता है और उसमें पाठ होता है। कमांड बैकस्लैश से शुरू होते हैं, और जो वे ग्रहण करते हैं वह धनु कोष्ठकों में लिखा जाता है।
यह स्रोत एक पूर्ण दस्तावेज़ है: यह बिना कुछ जोड़े कंपाइल होता है, और पाठ्यक्रम के दस्तावेज़ों का आरंभ-बिंदु होगा।
\documentclass{article}\usepackage{fontspec}\usepackage{babel}\babelprovide[import,main]{hindi}\babelfont{rm}[Script=Devanagari]{IBM Plex Sans Devanagari}\begin{document}\section{भूमिका}टाइपसेटिंग तय करती है कि हर अक्षर कहाँ पड़ेगा।\end{document}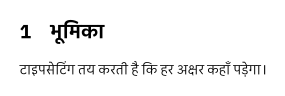
खंड को संख्या एक मिलती है, बिना किसी के लिखे, और उसका शीर्षक वही फ़ॉन्ट और आकार प्रयोग करता है जो article क्लास तय करती है। तीसरी से पाँचवीं पंक्ति हिंदी के लिए है: \babelprovide हिंदी भाषा का विवरण लोड करके उसे मुख्य भाषा बनाता है, और \babelfont देवनागरी वाला फ़ॉन्ट चुनता है, क्योंकि डिफ़ॉल्ट फ़ॉन्ट (Latin Modern) में देवनागरी नहीं है।
कार्य-चक्र के तीन चरण हैं: स्रोत लिखा जाता है, उसे कंपाइल किया जाता है, और परिणाम पढ़ा जाता है। कंपाइल करना फ़ाइल पर इंजन चलाना है, इस पाठ्यक्रम में lualatex कमांड से, जो स्रोत पढ़कर उसी नाम की PDF फ़ाइल लिखता है। उसके साथ सहायक फ़ाइलें रह जाती हैं, जिनमें एक .log एक्सटेंशन वाली लॉग फ़ाइल है, जिसमें इंजन त्रुटियाँ और चेतावनियाँ दर्ज करता है, और दूसरी .aux एक्सटेंशन वाली, जिसमें वह खंडों और पृष्ठों की संख्याएँ रखता है। इसीलिए विषय-सूची या कोई परस्पर-संदर्भ दूसरी बार कंपाइल करने के बाद ही सही दिखता है: पहली बार इंजन दर्ज करता है कि हर चीज़ कहाँ पहुँची; दूसरी बार वह उसका उपयोग करता है। व्यवहार में कमांड हाथ से नहीं लिखा जाता: संपादक उसे एक बटन से चलाता है। इस पाठ्यक्रम में अपने कंप्यूटर पर Texmaker से, या ब्राउज़र में Overleaf से, काम किया जाता है; अगला पाठ यह परिवेश तैयार करता है।
स्रोत जैसा लिखा जाता है वैसा टाइपसेट नहीं होता, और तीन नियम आरंभ के लगभग सारे आश्चर्यों को समझा देते हैं। पहला, लगातार कई रिक्त स्थान एक के बराबर होते हैं, और पंक्ति-विराम एक रिक्त स्थान माना जाता है: इंजन जगह अपने आप बाँटता है, और लेखक जो रिक्त स्थान लिखता है वह केवल यह बताता है कि वहाँ एक शब्द समाप्त होता है। दूसरा, एक या अधिक खाली पंक्तियाँ अनुच्छेद समाप्त करके नया शुरू करती हैं। तीसरा, चिह्न % एक टिप्पणी शुरू करता है: इंजन उसके बाद पंक्ति के अंत तक की हर चीज़ को अनदेखा करता है, स्वयं पंक्ति-विराम सहित।
नीचे का स्रोत जान-बूझकर लापरवाही से लिखा गया है। परिणाम में समान रिक्तियों वाले दो अनुच्छेद हैं, और टिप्पणी-चिह्न के बाद वाली टीप दिखाई नहीं देती।
दोहराए गए रिक्त स्थान एक में बदल जाते हैं, और यह पंक्ति-विरामभी एक रिक्त स्थान है।खाली पंक्ति नया अनुच्छेद खोलती है। % यह टीप नहीं छपती।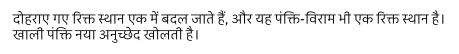
यदि ऐसा है, तो प्रतिशत चिह्न छापने के लिए उसे लिख देना काफ़ी नहीं: उसके पहले बैकस्लैश लगाना होगा, इस तरह: \%। यही बात उन दूसरे वर्णों पर लागू होती है जिन्हें LaTeX अपने कामों के लिए आरक्षित रखता है, जैसे धनु कोष्ठक या डॉलर का चिह्न।
अकादमिक विषयों में LaTeX
गणित, भौतिकी और कंप्यूटर विज्ञान के बड़े भाग में LaTeX ही मानक है: पत्रिकाएँ अपनी दस्तावेज़-क्लासें देती हैं ताकि लेखक लेख उनके प्रारूप में जमा करें, और arXiv, वह भंडार जहाँ इन विषयों के लेख प्रकाशन से पहले प्रसारित होते हैं, LaTeX स्रोत स्वीकार करता है और उन्हें स्वयं कंपाइल करता है। इसका कारण सूत्रों की टाइपसेटिंग है, जिसकी बराबरी कोई दूसरी प्रणाली इतने कम परिश्रम से नहीं करती, और प्रमेयों तथा समीकरणों का स्वचालित क्रमांकन। अर्थशास्त्र, सांख्यिकी, अभियांत्रिकी और रसायनशास्त्र भी इसका व्यापक उपयोग करते हैं।
फिर भी यह मानना भूल होगी कि LaTeX केवल सटीक विज्ञानों का विषय है। दर्शन, शास्त्रीय भाषाशास्त्र और इतिहास में इसके गुण अलग हैं, और कम नहीं। समीक्षात्मक संस्करणों के लिए, जो किसी प्राचीन पाठ के साथ एक ऐसा पाठभेद-संग्रह देते हैं जिसमें पांडुलिपियों के पाठांतर पंक्ति-संख्याओं से जुड़ी टिप्पणियों में दर्ज होते हैं, LaTeX में विशेष पैकेज हैं, जैसे reledmac, जो पंक्तियों को क्रमांकित करते हैं, टिप्पणियों के कई स्तरों को व्यवस्थित करते हैं और पाठ बदलने पर भी उनके संदर्भ बनाए रखते हैं। बहुस्वरी यूनानी और लैटिन सही ढंग से लिखी और विभाजित होती हैं, जैसा हमने देखा। पाद-टिप्पणियाँ, जो मानविकी के किसी निबंध में सैकड़ों हो सकती हैं, अपने आप क्रमांकित होकर अपने पृष्ठ पर रखी जाती हैं। और ग्रंथसूची BibLaTeX के साथ एक ही बार डेटाबेस के रूप में लिखी जाती है और माँगी गई किसी भी शैली में उद्धृत होती है, चाहे वह सामाजिक विज्ञानों की लेखक-वर्ष शैली हो, विज्ञानों की संख्यात्मक शैली, या मानविकी की पाद-टिप्पणी शैली, केवल एक विकल्प बदलकर।
LaTeX की सीमाएँ
परंतु LaTeX की वास्तविक लागतें हैं, और उसे अपनाने से पहले उन्हें जानना उचित है। उसका सीखने का वक्र कठिन है: शुरुआती हफ़्तों में बार-बार खोजना पड़ता है कि वह काम कैसे हो जो वर्ड प्रोसेसर में एक क्लिक से हो जाता है। TeX से विरासत में मिले उसके त्रुटि-संदेश प्रायः दुर्बोध होते हैं और कभी-कभी त्रुटि वाली पंक्ति के बाद की पंक्ति की ओर इशारा करते हैं; इस इकाई का एक आगामी पाठ उन्हें पढ़ना सिखाता है। मुक्त डिज़ाइन वाले पृष्ठों की टाइपसेटिंग, जैसे पोस्टर या सचित्र पत्रिका, जिनमें हर तत्व हाथ से रखा जाता है, पेज-लेआउट प्रोग्राम की तुलना में अधिक श्रमसाध्य है। और सभी प्राप्तकर्ता इसे स्वीकार नहीं करते: मानविकी की बहुत-सी पत्रिकाएँ, प्रकाशन-गृह और कार्यालय वर्ड प्रोसेसर की फ़ाइल माँगते हैं, और उसकी परिवर्तन-ट्रैकिंग से संशोधन करते हैं।
इससे एक सरल कसौटी निकलती है। छोटा पत्र, कार्यवृत्त, कोई प्रपत्र, या ऐसा पाठ जिसे कोई दूसरा व्यक्ति वर्ड प्रोसेसर में संशोधित करेगा, वर्ड प्रोसेसर में लिखना बेहतर है। संरचना, सूत्रों, उद्धरणों, टिप्पणियों, कई भाषाओं या आगे लंबे जीवन वाला लंबा दस्तावेज़, जिसे वर्षों तक सुधारा और फिर से प्रकाशित किया जाना है, LaTeX में लिखना बेहतर है।
हल किए गए प्रश्न
आगे के प्रश्न कही गई बातों को याद करने को नहीं, बल्कि उन्हें लागू करने को कहते हैं: पहला यह सटीक अनुमान माँगता है कि कोई स्रोत क्या उत्पन्न करता है, दूसरा यह निर्णय कि किसी दस्तावेज़ को कौन-सा इंजन और कौन-से फ़ॉन्ट चाहिए, और तीसरा, इस सावधानी के बिना लिखे गए स्रोत में विषय-वस्तु को रूप से अलग करना।
कंपाइल किए बिना, सटीक अनुमान लगाइए कि नीचे का मुख्य भाग कौन-सा पाठ उत्पन्न करता है, उसमें कितने अनुच्छेद हैं, और हर प्रतिशत चिह्न के साथ क्या होता है।
टाइपसेटिंग तय करती है कि हर अक्षर कहाँ पड़ेगा।अच्छा अनुच्छेद ध्यान नहीं खींचता।लगभग 50 % पाठकयह अंतर नहीं देखते। यह श%ब्द पूरा रहता है।हल
पहली तीन पंक्तियों के बीच कोई खाली पंक्ति नहीं है: वे एक ही अनुच्छेद बनाती हैं। दोहराए गए रिक्त स्थान और दूसरी पंक्ति के आरंभ वाले रिक्त स्थान एक में बदल जाते हैं, और हर पंक्ति-विराम एक रिक्त स्थान माना जाता है। पहला अनुच्छेद कहता है: “टाइपसेटिंग तय करती है कि हर अक्षर कहाँ पड़ेगा। अच्छा अनुच्छेद ध्यान नहीं खींचता।”
इसके बाद दो खाली पंक्तियाँ आती हैं। अनुच्छेद समाप्त करने के लिए एक ही काफ़ी है, और दूसरी कुछ नहीं जोड़ती: न कोई खाली अनुच्छेद बनता है, न बड़ी जगह। अतः दूसरा अनुच्छेद शुरू होता है।
पंक्ति
लगभग 50 % पाठकमें प्रतिशत चिह्न नहीं छपता: वह टिप्पणी शुरू करता है। इंजन “पाठक” को और पंक्ति-विराम को भी छोड़ देता है; केवल चिह्न से पहले लिखा रिक्त स्थान बचता है, और अगली पंक्ति वहीं से आगे चलती है।“श” में प्रतिशत चिह्न शब्द से सटा है: वह कोई रिक्त स्थान छोड़े बिना पंक्ति-विराम को हटा देता है, और इंजन अगली पंक्ति के आरंभ के रिक्त स्थानों को अनदेखा करता है। इससे यह निकलता है कि “श” और “ब्द” जुड़कर एक शब्द बन जाते हैं, और संयुक्ताक्षर भी ठीक बनता है।
दूसरा अनुच्छेद कहता है: “लगभग 50 यह अंतर नहीं देखते। यह शब्द पूरा रहता है।” लेखक प्रतिशत लिखना चाहता था और इंजन के किसी त्रुटि की सूचना दिए बिना आधा वाक्य खो बैठा; चिह्न छापने के लिए
\%लिखना चाहिए था।
दर्शनशास्त्र की एक छात्रा हिंदी में फ़ीडो पर शोध-प्रबंध लिख रही है। वह प्लेटो के अंश बहुस्वरी यूनानी में और लैटिन टीकाकारों के अंश उद्धृत करती है, और उसका विश्वविद्यालय एक निश्चित देवनागरी फ़ॉन्ट की माँग करता है, जो उसके कंप्यूटर पर OpenType फ़ाइल के रूप में स्थापित है और जिसमें यूनानी अक्षर नहीं हैं। तय कीजिए कि उसे कौन-सा इंजन चाहिए और दस्तावेज़ पूरा निकले, इसके लिए उसे और क्या घोषित करना होगा।
हल
pdfLaTeX दो स्वतंत्र कारणों से बाहर हो जाता है: वह सिस्टम के OpenType फ़ॉन्टों को सीधे लोड नहीं करता, और Unicode में लिखा यूनानी अक्षर उसका कंपाइलेशन रोक देता है, जब तक विशेष एन्कोडिंग और फ़ॉन्ट तैयार न किए जाएँ; देवनागरी भी उसमें विशेष पैकेजों के बिना नहीं चलती। पहला कारण ही उसे बाहर करने के लिए पर्याप्त है, क्योंकि संस्थागत फ़ॉन्ट अनिवार्य है।
XeLaTeX और LuaLaTeX Unicode पढ़ते हैं और fontspec से सिस्टम के फ़ॉन्ट लोड करते हैं: दोनों में से किसी के साथ, संस्थागत फ़ॉन्ट प्रस्तावना में घोषित होता है, यहाँ
\babelfontसे, क्योंकि वह मुख्य भाषा हिंदी का फ़ॉन्ट है। पाठ्यक्रम LuaLaTeX का उपयोग करता है।परंतु केवल इंजन काफ़ी नहीं। यदि फ़ॉन्ट में यूनानी अक्षर नहीं हैं, तो LuaLaTeX बिना त्रुटि के कंपाइल करता है, पर यूनानी शब्द PDF में नहीं दिखते: इंजन इसे केवल लॉग फ़ाइल में
Missing characterजैसी चेतावनियों से दर्ज करता है। समस्या कंपाइलेशन में नहीं, परिणाम पढ़ने पर दिखती है।अतः यूनानी को एक दूसरा फ़ॉन्ट देना होगा जिसमें वह हो। babel के साथ प्राचीन यूनानी को
\babelprovide[import]{ancientgreek}से भाषा घोषित किया जाता है और\babelfont[ancientgreek]{rm}{GFS Didot}से उसका फ़ॉन्ट दिया जाता है; हर यूनानी अंश\foreignlanguageसे चिह्नित होता है।लैटिन लैटिन वर्णमाला में लिखी जाती है; यदि संस्थागत फ़ॉन्ट में लैटिन अक्षर न हों तो उसे भी इसी तरह एक फ़ॉन्ट दिया जाता है, और हर स्थिति में उसे
\babelprovide[import]{latin}से भाषा घोषित किया जाता है, ताकि उसके शब्द लैटिन के नियमों से विभाजित हों।सारांश: LuaLaTeX, संस्थागत फ़ॉन्ट हिंदी के मुख्य फ़ॉन्ट के रूप में, यूनानी अंशों के लिए बहुस्वरी यूनानी वाला फ़ॉन्ट, और हिंदी, प्राचीन यूनानी तथा लैटिन भाषाओं के रूप में घोषित।
एक लेखक ने किसी लेख के दूसरे खंड का आरंभ इस तरह लिखा। बताइए कि कौन-से चिह्न विषय-वस्तु के बजाय रूप व्यक्त करते हैं, उन्हें ऐसे फिर से लिखिए कि वे केवल यह कहें कि हर चीज़ क्या है, और समझाइए कि यदि पत्रिका बाद में माँगे कि यूनानी पद तिरछे अक्षरों के बिना छपें, तो क्या लाभ होता है।
{\Large\bfseries 2. परिणाम}\\[6pt]जैसा कि अरस्तू \textit{Metaphysica} में कहते हैं, ज्ञान कीइच्छा \textit{स्वाभाविक} है; यूनानी पद \textit{φύσει} है।\\\vspace{12pt}{\large\bfseries 2.1. नमूना}\\हल
पहली पंक्ति हाथ से उस चीज़ का आकार, मोटाई, संख्या और दूरी तय करती है जो वास्तव में एक खंड का शीर्षक है। उसकी जगह
\section{परिणाम}लिखा जाता है, और संख्या क्लास देती है; हाथ से लिखी संख्या पहले कोई खंड जुड़ते ही गलत हो जाती।उस स्रोत में
\textitतीन बार आता है, तीन अलग कामों के लिए: वह एक कृति का शीर्षक, ज़ोर वाला एक शब्द और एक यूनानी पद चिह्नित करता है। तीनों का आज तिरछे अक्षरों में छपना रूप का संयोग है, विषय-वस्तु की एकता नहीं; और देवनागरी फ़ॉन्ट में तिरछे अक्षर न होने से ज़ोर वाला हिंदी शब्द तो बदला हुआ दिखेगा भी नहीं।हर काम को अपना चिह्न मिलता है। ज़ोर वाले शब्द के लिए
\emph{स्वाभाविक}है; बाकी दो के लिए प्रस्तावना में नए कमांड परिभाषित किए जाते हैं, उदाहरण के लिए\newcommand{\kriti}[1]{\textit{#1}}और उसी जैसा एक और,\pad, जिनका मुख्य भाग में\kriti{Metaphysica}और\pad{φύσει}की तरह उपयोग होता है।दोहरे बैकस्लैश, जो पंक्ति-विराम थोपते हैं, और हाथ से जोड़ी गई ऊर्ध्वाधर जगह अनुच्छेदों के बीच के अंतर की नकल करते हैं। उन्हें हटा दिया जाता है: खाली पंक्ति अनुच्छेद समाप्त करती है, और दूरी क्लास तय करती है। उपखंड का शीर्षक
\subsection{नमूना}लिखा जाता है।यदि पत्रिका यूनानी पद तिरछे अक्षरों के बिना माँगे, तो प्रस्तावना की केवल एक पंक्ति बदलनी होती है, वह जो
\padपरिभाषित करती है, और बदलाव लेख के सभी पदों तक पहुँचता है, कृतियों के शीर्षकों या ज़ोर वाले शब्दों को छुए बिना। मूल स्रोत के साथ, सारे तिरछे अक्षरों को एक-एक करके देखना पड़ता और हर बार तय करना पड़ता कि वह किस काम का था।
ऑनलाइन अभ्यास
इन अभ्यासों में कोड बॉक्स में लिखा जाता है और ब्राउज़र उसे तुरंत जाँचता है: वह कोष्ठकों, परिवेशों और हर अभ्यास की माँग की जाँच करता है, उसे कंपाइल किए बिना। जाँच में सफल होने पर कोड को Texmaker में कॉपी करके कंपाइल करना अच्छा है, क्योंकि केवल कंपाइल किया हुआ परिणाम दिखाता है कि वास्तव में क्या छपता है।
बॉक्स में स्पेनिश में लिखे एक दस्तावेज़ का केवल पाठ है; जाँच ठीक इसी पाठ को खोजती है, इसलिए उसे जैसा है वैसा रखना है। उसे पूरा कीजिए ताकि वह LuaLaTeX से कंपाइल होने वाला संपूर्ण दस्तावेज़ बन जाए: article क्लास, स्पेनिश के साथ fontspec और babel पैकेज, क्योंकि पाठ की भाषा स्पेनिश है, और मुख्य भाग का आरंभ और अंत। स्पेनिश लैटिन लिपि में लिखी जाती है, इसलिए किसी दूसरे फ़ॉन्ट की ज़रूरत नहीं। पाठ नहीं बदलता।
ब्राउज़र आपके कोड को तुरंत जाँचता है, बिना उसे कंपाइल किए और बिना अंक दिए। वास्तविक परिणाम देखने के लिए उसे Texmaker में कंपाइल करें।
संकेत
दस्तावेज़ के दो भाग होते हैं: प्रस्तावना, जो क्लास से शुरू होकर पैकेज लोड करती है, और मुख्य भाग, जिसमें पाठ होता है।
हल देखें
\documentclass{article}\usepackage{fontspec}\usepackage[spanish]{babel}\begin{document}\section{Introducción}La composición tipográfica decide dónde cae cada letra.\end{document}स्पेनिश के एक लेख से लिया गया नीचे का अंश बताता है कि हर पंक्ति कैसी दिखनी चाहिए, यह नहीं कि वह क्या है। उसे ऐसे फिर से लिखिए कि वह विषय-वस्तु चिह्नित करे: पहला शीर्षक एक खंड है और दूसरा एक उपखंड, दोनों क्लास द्वारा क्रमांकित, और “qué es” (“क्या है”) ज़ोर वाली अभिव्यक्ति है। पाठ नहीं बदलता (जाँच स्पेनिश शब्दों को खोजती है), और थोपे गए पंक्ति-विराम हट जाते हैं।
ब्राउज़र आपके कोड को तुरंत जाँचता है, बिना उसे कंपाइल किए और बिना अंक दिए। वास्तविक परिणाम देखने के लिए उसे Texmaker में कंपाइल करें।
संकेत
हर पंक्ति के लिए स्वयं से पूछिए कि वह क्या है (खंड का शीर्षक, उपखंड का शीर्षक, ज़ोर वाली अभिव्यक्ति) और वह कमांड खोजिए जो यही कहता है; बाकी सब क्लास तय करती है।
हल देखें
\section{Marcado y procesador de textos}En un lenguaje de marcado, el autor dice \emph{qué es} cada cosa.\subsection{El procesador de textos}El autor ve la página tal como se imprimirá.प्रस्तावित प्रश्न
हर प्रश्न के साथ एक संकेत है, जिसे स्वयं प्रयास करने के बाद ही खोलना अच्छा है, और एक उत्तर है, जो संकेत खोलने के बाद दिखता है।
अनुमान लगाइए कि नीचे का मुख्य भाग कौन-सा पाठ उत्पन्न करता है, जिसमें \LaTeX और \TeX वे कमांड हैं जो LaTeX और TeX के लोगो छापते हैं। दोनों पंक्तियों का अंतर समझाइए और पहली पंक्ति के लिए सुधार सुझाइए।
यह शोध-प्रबंध \LaTeX में लिखा गया है।इसमें \LaTeX{} और \TeX\ दोनों के लोगो हैं।संकेत
स्वयं से पूछिए कि अक्षरों से बने कमांड का नाम कहाँ समाप्त होता है, और इंजन उसके बाद आने वाले रिक्त स्थान के साथ क्या करता है: वह पाठ का हिस्सा है या कमांड का?
उत्तर
एक ही अनुच्छेद: “यह शोध-प्रबंध LaTeXमें लिखा गया है। इसमें LaTeX और TeX दोनों के लोगो हैं।” कमांड का नाम उस पहले वर्ण पर समाप्त होता है जो अक्षर नहीं है, और उसके बाद के रिक्त स्थान उसे पढ़ते समय सोख लिए जाते हैं; दूसरी पंक्ति में खाली धनु कोष्ठक और रिक्त स्थान के बाद वाला बैकस्लैश कमांड को बंद करते हैं और रिक्त स्थान बचाते हैं। पहली पंक्ति \LaTeX{} में से, या रिक्त स्थान से पहले बैकस्लैश लगाकर, सुधरती है। LuaLaTeX में देवनागरी के वर्ण भी अक्षर माने जाते हैं, इसलिए बिना रिक्त स्थान के \LaTeXमें किसी दूसरे, अस्तित्वहीन कमांड का नाम होता।
नीचे के हर दस्तावेज़ के लिए तय कीजिए कि वह किन इंजनों से बिना विशेष तैयारी के कंपाइल हो सकता है, और निर्णय का औचित्य बताइए: अंग्रेज़ी में गणित का एक शोध-प्रबंध, LaTeX के डिफ़ॉल्ट फ़ॉन्ट में टाइपसेट; लैटिन टिप्पणियों वाले एक यूनानी ग्रंथ का संस्करण, जिसे सिस्टम में स्थापित OpenType फ़ॉन्ट का उपयोग करना है; और हिंदी में एक लेख, जो अरबी और यूनानी स्रोतों को उद्धृत करता है। फिर समझाइए कि पाठ्यक्रम सबके लिए एक ही इंजन क्यों अपनाता है।
संकेत
हर दस्तावेज़ के लिए स्वयं से दो बातें पूछिए: क्या उसे सिस्टम का फ़ॉन्ट चाहिए, और क्या उसमें लैटिन वर्णमाला से भिन्न लिपियाँ हैं जिन्हें Unicode में पढ़ा जाना है और कुछ मामलों में अपने अक्षर जोड़ने या संयुक्त करने हैं।
उत्तर
गणित का शोध-प्रबंध तीनों इंजन स्वीकार करता है। यूनानी संस्करण को XeLaTeX या LuaLaTeX चाहिए, सिस्टम के फ़ॉन्ट के कारण और Unicode में यूनानी के कारण। हिंदी लेख को भी XeLaTeX या LuaLaTeX चाहिए, Unicode के कारण, देवनागरी और अरबी में जुड़ने और संयुक्त होने वाले अक्षरों के कारण, और अरबी में दाएँ से बाएँ लिखावट के कारण। LuaLaTeX तीनों के लिए काम करता है, और एक ही इंजन से पाठ्यक्रम के सारे स्रोत एक ही तरह कंपाइल होते हैं।
हर स्थिति के लिए तय कीजिए कि LaTeX उचित है या वर्ड प्रोसेसर, और निर्णय का औचित्य आदत से भिन्न किसी कसौटी से बताइए: किसी कार्यालय को भेजा जाने वाला दो पृष्ठों का पत्र; सूत्रों, क्रमांकित चित्रों और डेढ़ सौ संदर्भों वाला दो सौ पृष्ठों का शोध-प्रबंध; इतिहास की एक पत्रिका के लिए लेख, जो केवल वर्ड प्रोसेसर की फ़ाइलें स्वीकार करती है और परिवर्तन-ट्रैकिंग से संशोधन करती है; और यूनानी उद्धरणों वाले कक्षा-नोट्स, जिन्हें उनका लेखक कई वर्षों तक बढ़ाता रहेगा।
संकेत
हर स्थिति में दस्तावेज़ की लंबाई और संरचना पर विचार कीजिए, वह कितने समय जीवित रहेगा और उसकी फ़ाइल को और कौन पढ़ेगा या बदलेगा, केवल छपे परिणाम पर नहीं।
उत्तर
पत्र वर्ड प्रोसेसर में: वह छोटा है, बिना संरचना और बिना आगे के जीवन के। शोध-प्रबंध LaTeX में: उसकी लंबाई, सूत्रों और संदर्भों को स्वचालित क्रमांकन और डेटाबेस के रूप में ग्रंथसूची से लाभ होता है। लेख वर्ड प्रोसेसर में, क्योंकि प्राप्तकर्ता यही माँगता है। नोट्स LaTeX में: उनका लंबा जीवन, बढ़ती संरचना और यूनानी सादे पाठ और Unicode के पक्ष में हैं।