

 Español
 English
 Português
 中文 (中国)
 العربية
 हिन्दी
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 日本語
 Latine
요약
이 강의에서는 LaTeX가 무엇이며 학계가 왜 그것을 쓰는지 설명한다. 글자 하나, 줄 하나, 쪽 하나를 배치하는 기술인 조판과 학술 문서에 고유한 요구에서 출발한다. 마크업 언어와 워드프로세서를 공정하게 비교한다. Donald Knuth가 왜 TeX를 만들었고 Leslie Lamport가 그 위에 어떻게 LaTeX를 세웠는지 이야기하는데, LaTeX의 원리는 내용을 형식에서 분리하는 것이다. 오늘날 컴파일에 쓰이는 세 엔진 pdfLaTeX, XeLaTeX, LuaLaTeX를 구별하고, 이 강좌가 LuaLaTeX를 택하는 이유를 밝힌다. 원본 파일이 어떻게 생겼고 어떻게 PDF 문서가 되는지 보인다. 수학과 물리학에서 철학과 문헌학에 이르기까지 여러 분야에서의 쓰임을 살펴본다. 끝으로 그 한계를 다루어, 언제 워드프로세서로 충분한지 알 수 있게 한다.
학습 목표
- 조판이 무엇인지, 그리고 학술 문서가 왜 다른 문서보다 조판을 더 많이 요구하는지 설명한다.
- 마크업 언어와 워드프로세서를 비교하고, 각각의 장점과 대가를 지적한다.
- TeX와 LaTeX를 구별하고, 내용을 형식에서 분리한다는 것이 무엇인지 예를 들어 설명한다.
- 문서의 언어, 문자 체계, 글꼴에 따라 알맞은 엔진을 고른다.
- 공백, 문단, 주석에 주의하여 짧은 원본이 무엇을 출력할지 예측한다.
조판
인쇄된 글이든 화면으로 읽는 글이든 모두 조판된 것이다. 누군가 또는 무엇인가가 각 글자가 어디에 놓일지를 정확히 정한 것이다. 조판은 이러한 결정의 총체이다. 어떤 글꼴을 어떤 크기로 쓸지, 각 줄을 어디서 끝내고 양쪽을 맞추기 위해 낱말 사이의 공간을 어떻게 나눌지, 어떤 낱말을 줄 끝에서 하이픈으로 나누고 어디서 자를지, 두 글자를 언제 합자로 합칠지, 특정한 글자 쌍 사이의 간격을 어떻게 조정할지(커닝), 각 쪽을 어디서 넘길지, 각주를 어느 높이에 둘지, 제목을 어떻게 배열할지가 그것이다. 수백 년 동안 이것은 금속 활자로 줄을 짜던 식자공의 일이었다. 오늘날에는 프로그램이 이 일을 하지만, 내려야 할 결정은 그대로이다.
좋은 문단은 눈에 띄지 않는다. 눈은 고르지 않은 빈틈이나 엉뚱한 낱말 나누기에 걸리지 않고 줄을 따라간다. 그러나 이를 이루기는 쉽지 않다. 하나의 결정이 그다음 결정들을 좌우하기 때문이다. 첫 줄이 어디서 끝나는지가 둘째 줄이 어떤 낱말로 시작할지를 정하고, 이것이 문단 끝까지 이어진다.
단순한 방법은 각 줄에 들어갈 만큼 낱말을 채우고 다음 줄로 넘어가며, 결코 뒤로 돌아가지 않는다. 긴 낱말이 셋째 줄 끝에 들어가지 않으면 그 줄은 낱말 사이가 크게 벌어진 채 남는다. 둘째 줄에서 짧은 낱말 하나만 옮겼어도 피할 수 있었는데도 말이다. Knuth와 Michael Plass가 TeX를 위해 고안한 방법은 다르게 움직인다. 문단에서 가능한 모든 줄바꿈 위치를 한꺼번에 검토하여 전체적으로 공백을 가장 잘 나누는 조합을 고른다. 따라서 뒤따르는 줄들이 나아진다면, 어떤 줄은 채울 수 있었던 것보다 조금 덜 채워진 채 남을 수 있다.
학술 문서는 다른 문서보다 이러한 주의를 더 많이 요구한다. 학술 문서에는 수식이 들어 있고, 수식의 조판은 고유한 규칙을 따른다(등호 둘레의 간격은 쉼표 둘레의 간격과 다르고, 아래 첨자는 정해진 비율로 줄어든다). 또 번호가 붙은 절, 정리, 그림, 수식을 번호로 인용하면서 끊임없이 자기 자신을 참조한다. 각주와 참고문헌이 쌓이며, 이들은 통일된 양식을 따라야 한다. 여러 언어와 여러 문자 체계가 섞이는 일도 많다. 그리고 대개 길어서, 백 쪽에 걸쳐 되풀이된 부주의는 손으로 고칠 수 없다. 그렇다면 조판은 명시적인 규칙으로 그것을 해결하는 시스템에 맡기고, 저자는 자신이 말하는 내용에 전념하는 것이 낫다.
마크업과 워드프로세서
프로그램에 글을 조판하게 하는 방법은 두 가지이다. Microsoft Word나 LibreOffice Writer 같은 워드프로세서에서 저자는 인쇄될 모습 그대로의 쪽을 화면에서 보며 직접 고친다. 낱말을 골라 기울임꼴로 바꾸고, 여백을 끌어 옮기고, 제목에 더 큰 글자 크기를 고른다. 이 방식은 흔히 영어 표현 what you see is what you get(보이는 대로 얻는다)으로 설명된다.
반면 마크업 언어에서 저자는 일반 텍스트 파일을 쓰고, 그 안에 각각이 무엇인지 또는 어떻게 다루어야 하는지를 말하는 표시를 끼워 넣는다. 이 낱말은 강조된다, 이 줄은 절의 제목이다, 이 부분은 인용이다 하는 식이다. 그런 다음 프로그램이 이 파일을 읽어 조판된 문서를 만든다. 웹 페이지가 이렇게 HTML로 쓰인다. LaTeX는 질 높은 인쇄 문서를 만들기 위해 설계된 마크업 언어이다.
비교가 공정하려면 각 방식이 무엇을 더 잘하는지 인정해야 한다. 워드프로세서는 곧바로 결과를 보여 주고, 사전 학습을 거의 요구하지 않으며, 함께 일하는 사람 대부분이 아는 도구이고, 그 변경 내용 추적 기능은 많은 출판사와 사무실에서 교정의 일반적인 수단이다. 마크업 언어는 그 나름으로 다음을 제공한다. 어떤 프로그램이든 사십 년 뒤에도 열 수 있고, 용량이 작으며, 판본끼리 줄 단위로 비교할 수 있는 일반 텍스트 파일. 차례, 번호 매기기, 상호 참조가 저절로 따라 나오는 명시적인 구조. 저자의 꼼꼼함에 좌우되지 않는 일관성. 그리고 워드프로세서가 이르지 못하는 수식과 문단의 조판. 그 대가도 그만큼 분명하다. 표시를 배워야 하고, 컴파일하기 전에는 결과가 보이지 않으며, 입력 실수 하나로 컴파일이 멈출 수 있다.
TeX와 LaTeX
Donald Knuth와 TeX
스탠퍼드 대학교의 컴퓨터 과학 교수 Donald Knuth는 1968년부터 The Art of Computer Programming의 각 권을 펴내고 있었다. 1977년 무렵 그는 둘째 권 새 판의 교정쇄를 받았는데, 그것은 금속 활자를 대신하게 된 사진 식자로 조판된 것이었고, 그는 그것이 초판보다 훨씬 못하다고 판단했다. 특히 수식이 그러했다. 그는 체념하지 않고, 수학 책에 가장 뛰어난 전통 인쇄의 품질을 되돌려 주고 어느 컴퓨터에서나 똑같은 출력을 내는 조판 프로그램을 직접 쓰기로 했다. TeX의 첫 판은 1978년에 나왔다. Knuth는 다음 십 년이 시작될 무렵 이를 완전히 다시 썼고, METAFONT라는 프로그램도 설계하여 그것으로 Computer Modern 글꼴을 그렸다.
이름은 그리스어에서 왔다. 그 글자들은 대문자 타우, 엡실론, 키로, 예술과 기술을 함께 뜻하는 낱말 τέχνη의 첫머리이다. 그래서 마지막 글자는 영어의 x처럼 읽지 않으며, 우리말로는 흔히 ‘텍’이라고 부른다. Knuth는 TeX가 완성되었다고 선언했고, 오류 수정만을 받아들인다. 판 3 이후로 판 번호는 π에 다가가며, 수정할 때마다 자릿수가 하나씩 늘어난다. 이 안정성은 TeX의 장점 가운데 하나이다. 수십 년 전에 쓴 문서도 오늘 같은 결과로 컴파일되기 때문이다.
그러나 TeX는 저수준 언어이다. 그 기본 명령은 상자, 늘었다 줄었다 하는 공백, 그리고 줄을 이곳저곳에서 끊는 데 매기는 벌점을 이야기한다. 논문 한 편을 쓰려는 저자에게 제목 하나, 각주 하나까지 이런 용어로 프로그래밍하라는 것은 지나친 부담이다. 그래서 TeX는 매크로, 곧 더 기본적인 명령으로 펼쳐지는 새 명령을 정의할 수 있게 하며, 실제 쓰임은 거의 모두 매크로 모음을 거친다.
Leslie Lamport와 LaTeX: 형식에서 분리된 내용
1980년대 초, 분산 시스템 연구로 특히 잘 알려진 컴퓨터 과학자 Leslie Lamport는 TeX 위에 매크로 모음을 써서 LaTeX라고 이름 붙였다. 그 첫 판은 1984년에 퍼졌고, 1986년에 그는 안내서 LaTeX: A Document Preparation System을 펴냈다. 1994년부터는 LaTeX2e라 불리는 현행 판을 자원봉사자 모임인 LaTeX Project가 관리한다.
LaTeX의 중심 생각은 저자가 형식이 아니라 내용을 표시한다는 것이다. 저자는 “이 줄은 굵게, 더 큰 글자로”라고 쓰지 않고 “이것은 절의 제목이다”라고 \section{결과}로 쓴다. “이 낱말은 기울임꼴로”라고 쓰지 않고 “이 낱말은 강조된다”라고 \emph{가설}로 쓴다. 절 제목이 어떤 모양인지, 번호가 붙는지, 본문과 얼마나 떨어지는지는 처음에 선언하는 문서 클래스와 저자가 프리앰블에 덧붙이는 명령이 정한다. 따라서 문서 전체의 모양은 한 곳에서 바뀌고, 같은 글을 본문의 한 줄도 건드리지 않고 서로 다른 두 학술지의 규정에 맞추어 조판할 수 있다.
다음 원본에는 크기, 글꼴, 번호에 관한 지시가 하나도 없다. 각 줄이 무엇인지만 말할 뿐이다. 절과 소절의 번호, 그 제목의 크기와 굵기, 강조된 낱말의 모양은 문서 클래스가 정한다. 한글에는 기본 기울임꼴이 적용되지 않으므로, 여기서는 괄호 안의 로마자 용어를 강조했고, 그것이 로마자의 관례대로 기울임꼴로 조판된다. 한글의 강조 방식은 따로 정한다.
\section{결과}자료는 처음의 가설(\emph{hypothesis})을 뒷받침한다.\subsection{표본}표본은 저자 세 명의 텍스트 열두 편으로 이루어진다.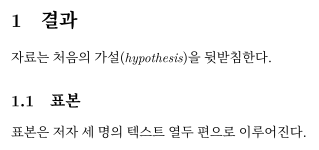
나중에 이 절 앞에 다른 절을 넣으면, 이 절의 번호는 저절로 1에서 2로 바뀌고, 소절과 그것들을 가리키는 모든 참조도 마찬가지로 바뀐다.
엔진: pdfLaTeX, XeLaTeX, LuaLaTeX
LaTeX는 매크로의 모음이지 프로그램이 아니다. 그것을 실행하여 문서를 만들어 내는 TeX 계열의 프로그램, 곧 엔진이 필요하다. 오늘날 쓰이는 엔진은 셋이며, 셋 모두 같은 LaTeX를 이해한다. 차이는 텍스트를 읽는 방식과 쓸 수 있는 글꼴에 있다.
- pdfLaTeX는 pdfTeX 엔진을 쓴다. 이는 Hàn Thế Thành이 PDF 파일을 곧바로 만들기 위해 개발한 것이다. 빠르고 널리 퍼져 있으며, Overleaf의 기본 엔진이다. 그러나 그 글꼴은 TeX의 고전적인 형식으로, 글꼴 하나에 최대 256자까지만 담을 수 있어서 시스템에 설치된 글꼴을 직접 불러오지 못한다. 그리스 문자, 키릴 문자, 한글 같은 문자를 쓰려면 특별한 인코딩과 패키지가 필요하며, 그것이 없으면 그리스 문자 하나가 오류를 내며 컴파일을 멈춘다.
- XeLaTeX는 Jonathan Kew가 만든 XeTeX 엔진을 쓴다. 이 엔진은 모든 문자 체계의 모든 문자에 번호를 매기는 표준인 유니코드로 텍스트를 읽고, fontspec 패키지를 통해 시스템의 어떤 OpenType 글꼴이든 불러온다.
- LuaLaTeX는 LuaTeX 엔진을 쓴다. 유니코드와 글꼴에 관해서는 XeTeX와 같은 기능을 갖추었고, 여기에 프로그래밍 언어 Lua를 품고 있어서 패키지가 그것으로 조판에 개입할 수 있다. 현재의 배포판은 HarfBuzz 라이브러리와 함께 이를 실행하는데, 이 라이브러리는 아랍 문자나 데바나가리처럼 글자가 이어지거나 결합하는 문자 체계의 모양을 잡아 준다.
이 강좌는 LuaLaTeX를 쓴다. 이유는 앞의 이야기에서 따라 나온다. 유니코드로 곧바로 쓰므로, 악센트와 기식 부호가 붙은 다성조 그리스어로 된 플라톤 인용문도 그대로 입력할 수 있다. 대학이나 학술지가 지정하는 글꼴을 포함해 시스템의 글꼴을 쓸 수 있다. 한국어, 그리스어, 라틴어를 한 문서 안에서 각각의 규칙에 따라 조판한다. 그리고 알맞은 패키지를 쓰면 아랍어처럼 오른쪽에서 왼쪽으로 쓰는 문자 체계나, 중국어와 일본어처럼 낱말을 공백으로 나누지 않는 문자 체계도 다룬다. 한국어 문서에 널리 쓰이는 kotex 역시 LuaLaTeX에서 쓸 수 있다. 따라서 이공계와 인문계를 함께 대상으로 하는 강좌의 모든 문서에 엔진 하나로 충분하다. pdfLaTeX에 비해 유일한 대가는 컴파일이 조금 느리다는 것인데, 보통 분량의 문서에서는 거의 느껴지지 않는다.
다음 원본은 한글을 조판하기 위해 kotex를 불러오고, 한글과 로마자의 글꼴을 각각 고른다. kotex는 그리스 문자를 한글 글꼴이 아니라 로마자 글꼴로 조판하므로, 로마자 글꼴로는 다성조 그리스 문자를 갖춘 Linux Libertine O를 고른다. 이어서 babel로 한국어를 주 언어로, 고대 그리스어와 라틴어를 보조 언어로 선언한다. 그리스어 낱말은 그 문자로 곧바로 쓴다.
\documentclass{article}\usepackage[hangul]{kotex}\setmainhangulfont{Noto Serif CJK KR}\setmainfont{Linux Libertine O}\usepackage{babel}\babelprovide[import,main]{korean}\babelprovide[import]{ancientgreek}\babelprovide[import]{latin}\begin{document}아리스토텔레스는 『형이상학』을 이 문장으로 시작한다:\foreignlanguage{ancientgreek}{πάντες ἄνθρωποι τοῦ εἰδέναι ὀρέγονται φύσει.}라틴 전통은 이를 이렇게 전했다:\foreignlanguage{latin}{omnes homines natura scire desiderant.}\end{document}
\foreignlanguage로 어떤 부분을 표시해도 글자의 모양은 바뀌지 않는다. 그 부분이 어느 언어인지 알려 주어, 그 언어의 낱말 나누기 규칙과 관례가 적용되게 하는 것이다. 이 원본은 pdfLaTeX로는 컴파일되지 않는다. fontspec(kotex는 LuaLaTeX에서 이것을 불러온다)은 XeLaTeX나 LuaLaTeX를 요구하기 때문이다.
원본 파일, 컴파일, PDF
LaTeX 문서는 확장자가 .tex인 일반 텍스트 파일이다. 이는 두 부분으로 이루어진다. 프리앰블은 문서 클래스를 선언하는 첫 줄 \documentclass{article}에서 \begin{document}까지이며, 여기서 \usepackage로 패키지를 불러오고 형식에 관한 결정을 정한다. 본문은 \begin{document}에서 \end{document}까지이며 글을 담는다. 명령은 역슬래시로 시작하고, 명령이 받는 것은 중괄호 안에 쓴다.
이 원본은 완전한 문서이다. 아무것도 덧붙이지 않고 컴파일되며, 이 강좌에서 쓰는 문서들의 출발점이 된다.
\documentclass{article}\usepackage[hangul]{kotex}\setmainhangulfont{Noto Serif CJK KR}\begin{document}\section{들어가며}조판은 글자 하나하나가 놓일 자리를 정한다.\end{document}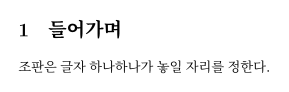
절에는 적지 않은 번호 1이 붙고, 제목에는 article 클래스가 정한 글꼴과 크기가 쓰인다. 둘째 줄과 셋째 줄은 한글을 위한 설정이다. kotex 패키지는 LuaLaTeX에서 한글 조판 기능을 더하고(fontspec도 이 패키지가 불러온다), \setmainhangulfont는 한글이 들어 있는 글꼴(여기서는 Noto Serif CJK KR)을 고른다. 기본 글꼴(Latin Modern)에는 한글이 없기 때문이다. 옵션 hangul은 “차례”, “그림”, “표”처럼 LaTeX가 자동으로 붙이는 이름과 날짜를 한국어로 바꾸고, 줄 간격과 문장 사이의 공백을 한국어 조판에 맞춘다.
작업은 세 단계로 돈다. 원본을 쓰고, 컴파일하고, 결과를 읽는다. 컴파일이란 파일에 엔진을 실행하는 것으로, 이 강좌에서는 lualatex 명령을 쓴다. 이 명령은 원본을 읽고 같은 이름의 PDF 파일을 써 낸다. 그 곁에는 보조 파일들이 남는데, 그 가운데 확장자가 .log인 로그 파일에는 엔진이 오류와 경고를 기록하고, 확장자가 .aux인 파일에는 절과 쪽의 번호를 저장한다. 그래서 차례나 상호 참조는 두 번째 컴파일 뒤에야 제대로 나타난다. 첫 번째 컴파일에서 엔진은 각각이 어디에 놓였는지 적어 두고, 두 번째에 그것을 이용한다. 실제로는 명령을 손으로 입력하지 않고, 편집기가 단추 하나로 실행한다. 이 강좌에서는 자기 컴퓨터에서 Texmaker를 쓰거나 브라우저에서 Overleaf를 쓴다. 그 환경은 다음 강의에서 마련한다.
원본은 쓴 그대로 조판되지 않으며, 처음에 겪는 놀라움은 대부분 세 가지 규칙으로 설명된다. 첫째, 잇달아 쓴 여러 공백은 공백 하나와 같고, 줄바꿈도 공백 하나로 친다. 공간은 엔진이 스스로 나누므로, 저자가 쓰는 공백은 거기서 낱말이 끝난다는 것만 알릴 뿐이다. 이 강좌의 한국어 예에서 쓰는 kotex도 이 규칙을 그대로 따르므로, 한글 음절 뒤의 줄바꿈도 공백이 된다. 둘째, 하나 이상의 빈 줄은 문단을 끝내고 새 문단을 시작한다. 셋째, 기호 %는 주석을 시작한다. 엔진은 그 뒤로 줄 끝까지 오는 모든 것을, 줄바꿈 자체까지 포함하여 무시한다.
다음 원본은 일부러 아무렇게나 썼다. 결과는 공백이 고른 두 문단이 되고, 주석 기호 뒤의 메모는 나타나지 않는다.
되풀이된 공백은 하나로 줄어들고, 쉼표 뒤의 이 줄바꿈도 공백이 된다.그래서 세 줄이 한 문단을 이룬다.빈 줄은 새 문단을 연다. % 이 메모는 출력되지 않는다.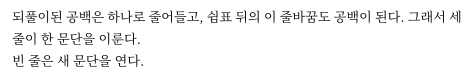
그렇다면 퍼센트 기호를 출력하려면 그것을 쓰는 것만으로는 부족하다. 앞에 역슬래시를 붙여 \%처럼 써야 한다. LaTeX가 자기 기능을 위해 예약해 둔 다른 문자들, 이를테면 중괄호나 달러 기호도 마찬가지이다.
학문 분야의 LaTeX
수학, 물리학, 그리고 컴퓨터 과학의 상당 부분에서 LaTeX는 표준이다. 학술지는 자체 문서 클래스를 제공하여 저자가 그 형식으로 논문을 내게 하고, 이들 분야의 논문이 출판 전에 공개되는 저장소인 arXiv는 LaTeX 원본을 받아 스스로 컴파일한다. 그 이유는 수식 조판에 있다. 이만큼 적은 수고로 그에 견줄 만한 시스템은 없으며, 정리와 수식에 자동으로 번호를 매기는 기능도 있다. 경제학, 통계학, 공학, 화학에서도 널리 쓰인다.
그러나 LaTeX를 정밀 과학만의 일로 여기는 것은 잘못이다. 철학, 고전 문헌학, 역사학에서 그 장점은 다른 데 있으며, 결코 작지 않다. 고대 텍스트에 사본들의 이문을 줄 번호에 연결된 주로 기록하는 교감 자료를 붙이는 비판 정본을 위해, LaTeX에는 reledmac 같은 전용 패키지가 있다. 이 패키지는 줄에 번호를 매기고, 여러 층의 주를 정리하며, 텍스트가 바뀌어도 그 참조를 유지한다. 다성조 그리스어와 라틴어도 앞에서 본 것처럼 올바르게 쓰이고 올바르게 나뉜다. 인문학 논문에서 수백 개에 이를 수 있는 각주는 저절로 번호가 매겨져 제 쪽에 놓인다. 그리고 참고문헌은 BibLaTeX를 쓰면 데이터베이스로 한 번만 써 두고, 사회과학의 저자-연도 방식이든, 이공계의 번호 방식이든, 인문학의 각주 방식이든, 요구되는 양식으로 옵션 하나만 바꾸어 인용할 수 있다.
LaTeX의 한계
그렇지만 LaTeX에는 실제 대가가 있으며, 받아들이기 전에 알아 두는 것이 좋다. 학습 곡선이 가파르다. 처음 몇 주 동안은 워드프로세서라면 클릭 한 번으로 되는 일을 어떻게 하는지 자주 찾아보아야 한다. TeX에서 물려받은 오류 메시지는 흔히 알아보기 어렵고, 때로는 오류가 있는 줄보다 뒤의 줄을 가리킨다. 이 단원의 다음 강의 가운데 하나에서 그 읽는 법을 배운다. 포스터나 화보 잡지처럼 요소 하나하나를 손으로 배치하는 자유로운 디자인의 쪽은 편집 디자인 프로그램보다 손이 많이 간다. 그리고 받는 쪽이 모두 그것을 받아들이는 것은 아니다. 적지 않은 인문학 학술지, 출판사, 사무실이 워드프로세서 파일을 요구하고, 그 변경 내용 추적 기능으로 교정한다.
여기서 간단한 기준이 나온다. 짧은 편지, 회의록, 서식, 또는 다른 사람이 워드프로세서에서 고칠 글은 워드프로세서로 쓰는 편이 낫다. 구조, 수식, 인용, 주, 여러 언어를 갖춘 긴 문서, 또는 여러 해에 걸쳐 고치고 다시 펴낼 긴 수명을 앞둔 문서는 LaTeX로 쓰는 편이 낫다.
풀이가 있는 문제
다음 문제들은 앞에서 말한 것을 떠올리기보다 적용하기를 요구한다. 첫째 문제는 원본이 무엇을 출력할지 정확히 예측하기를, 둘째 문제는 문서에 어떤 엔진과 어떤 글꼴이 필요한지 판단하기를, 셋째 문제는 그런 주의 없이 쓴 원본에서 내용을 형식에서 분리하기를 요구한다.
컴파일하지 않고, 다음 본문이 출력하는 글과 문단의 수, 그리고 각 퍼센트 기호에 무슨 일이 일어나는지 정확히 예측하라.
조판은 글자 하나하나의 자리를 정한다. 좋은 문단은 눈에 띄지 않고,편하게 읽힌다.독자의 50 %가차이를 알아채지 못한다. 이 낱%말은 끊기지 않는다.풀이
처음 세 줄 사이에는 빈 줄이 없으므로 한 문단을 이룬다. 되풀이된 공백과 둘째 줄 첫머리의 공백은 하나로 줄고, 줄바꿈은 각각 공백 하나로 친다. 첫째 문단은 “조판은 글자 하나하나의 자리를 정한다. 좋은 문단은 눈에 띄지 않고, 편하게 읽힌다.”이다.
이어서 빈 줄이 두 개 있다. 문단을 끝내는 데는 하나로 충분하고, 둘째 빈 줄은 아무것도 더하지 않는다. 빈 문단도, 더 큰 간격도 생기지 않는다. 따라서 여기서 둘째 문단이 시작된다.
독자의 50 %가줄에서 퍼센트 기호는 출력되지 않는다. 그것은 주석을 시작한다. 엔진은 “가”와 줄바꿈을 버린다. 기호 앞에 쓴 공백만 남고, 다음 줄은 거기서 이어진다.“낱”에서는 퍼센트 기호가 낱말에 붙어 있다. 그것은 공백을 남기지 않고 줄바꿈을 버리며, 엔진은 다음 줄 첫머리의 공백도 건너뛴다. 따라서 “낱”과 “말은”은 한 낱말로 이어진다.
둘째 문단은 “독자의 50 차이를 알아채지 못한다. 이 낱말은 끊기지 않는다.”이다. 저자는 백분율을 쓰려다가 문장 일부를 잃었는데, 엔진은 아무 오류도 알리지 않았다. 기호를 출력하려면
\%라고 써야 했다.
철학을 전공하는 한 학생이 한국어로 『파이돈』에 관한 학위 논문을 쓰고 있다. 학생은 플라톤의 다성조 그리스어 원문과 라틴어 주석가들의 글을 인용하며, 대학은 특정한 글꼴을 쓰도록 요구한다. 그 글꼴은 OpenType 파일로 학생의 컴퓨터에 설치되어 있지만 그리스 문자는 들어 있지 않다. 필요한 엔진과, 문서가 빠짐없이 출력되도록 더 선언해야 할 것을 판단하라.
풀이
pdfLaTeX는 서로 독립된 두 가지 이유로 제외된다. 시스템의 OpenType 글꼴을 직접 불러오지 못하고, 특별한 인코딩과 글꼴을 준비하지 않으면 유니코드로 쓴 그리스 문자가 컴파일을 멈추게 한다. 대학이 지정한 글꼴은 반드시 써야 하므로 첫째 이유만으로도 제외하기에 충분하다.
XeLaTeX와 LuaLaTeX는 유니코드를 읽고 fontspec으로 시스템 글꼴을 불러온다. 어느 쪽을 쓰든 대학 지정 글꼴은 프리앰블에서 선언하는데, 로마자 글꼴은
\setmainfont로, 한글 글꼴은\setmainhangulfont로 지정한다. 이 강좌는 LuaLaTeX를 쓴다.그러나 엔진만으로는 부족하다. 글꼴에 그리스 문자가 없으면 LuaLaTeX는 오류 없이 컴파일하지만, 그리스어 낱말은 PDF에 나타나지 않는다. 엔진은 로그 파일에
Missing character같은 경고로만 이를 기록한다. 문제는 컴파일할 때가 아니라 결과를 읽을 때 드러난다.따라서 그리스어에는 그것을 담은 둘째 글꼴을 배정해야 한다. babel을 써서
\babelprovide[import]{ancientgreek}로 고대 그리스어를 언어로 선언하고,\babelfont[ancientgreek]{rm}{GFS Didot}로 글꼴을 배정한다. 그리스어 부분마다\foreignlanguage로 표시한다. kotex는 로마자 글꼴에 없는 글자를 한글 글꼴에서 가져와 채우기도 하지만, 한글 글꼴에는 다성조 그리스 문자가 없으므로 이 배정은 그대로 필요하다.라틴어는 로마자로 쓰며, 대학 지정 글꼴에 그 글자들이 들어 있다. 다른 글꼴은 필요 없고, babel의
\babelprovide[import]{latin}으로 언어로 선언하기만 하면 된다. 그러면 그 낱말들이 영어가 아닌 라틴어의 규칙에 따라 나뉜다.정리하면, LuaLaTeX, 주 글꼴로서의 대학 지정 글꼴, 그리스어 부분을 위한 다성조 그리스 문자가 든 글꼴, 그리고 언어로 선언한 한국어, 고대 그리스어, 라틴어이다.
어떤 저자가 논문 둘째 절의 첫머리를 이렇게 썼다. 내용 대신 형식을 나타내는 표시를 지적하고, 그것들이 각각 무엇인지만 말하도록 다시 쓰고, 나중에 학술지가 그리스어 용어를 기울임꼴 없이 싣도록 요구할 때 무엇을 얻는지 설명하라.
{\Large\bfseries 2. 결과}\\[6pt]아리스토텔레스가 \textit{Metaphysica}에서 말하듯이,앎을 향한 욕구는 \textit{자연스러운} 것이며, 그리스어 용어는 \textit{φύσει}이다.\\\vspace{12pt}{\large\bfseries 2.1. 표본}\\풀이
첫 줄은 실제로는 절의 제목인 것의 크기, 굵기, 번호, 간격을 손으로 정하고 있다. 이를
\section{결과}로 바꾸고, 번호는 클래스가 붙이게 한다. 손으로 쓴 번호는 앞에 절이 하나 끼어드는 순간 어긋난다.이 원본에서
\textit는 세 번, 서로 다른 세 가지 역할로 쓰였다. 작품의 제목, 강조된 낱말, 그리스어 용어를 표시하는 것이다. 셋이 오늘 모두 기울임꼴로 출력되는 것은 형식의 우연한 일치일 뿐, 내용이 같은 것은 아니다. 게다가 한글에는 기울임꼴이 적용되지 않으므로 “자연스러운”은 실제로는 강조되어 보이지도 않는다.역할마다 고유한 표시를 준다. 강조된 낱말에는
\emph{자연스러운}이 있다. 나머지 둘을 위해서는 프리앰블에 새 명령을 정의한다. 예를 들어\newcommand{\jakpum}[1]{\textit{#1}}와 이와 비슷한\yongeo를 정의하고, 본문에서는\jakpum{Metaphysica},\yongeo{φύσει}처럼 쓴다. 한글의 강조 방식도 굵은 글꼴이나 드러냄표 등으로 프리앰블에서 정할 수 있다.줄바꿈을 강제하는 두 겹의 역슬래시와 손으로 넣은 수직 간격은 문단 사이의 구분을 흉내 낸 것이다. 이것들은 지운다. 문단은 빈 줄로 끝내고, 간격은 클래스가 정한다. 소절 제목은
\subsection{표본}으로 쓴다.학술지가 그리스어 용어를 기울임꼴 없이 요구하면, 프리앰블의 한 줄, 곧
\yongeo를 정의하는 줄만 바꾸면 된다. 그러면 작품 제목이나 강조된 낱말은 건드리지 않고 논문의 모든 용어에 변경이 미친다. 원래의 원본으로는 기울임꼴을 하나하나 살피며, 그때마다 어느 역할에 해당하는지 판단해야 할 것이다.
온라인 연습
이 연습에서는 입력란에 코드를 쓰면 브라우저가 곧바로 점검한다. 컴파일하지 않고 중괄호, 환경, 각 연습이 요구하는 내용을 확인한다. 점검을 통과하면 코드를 Texmaker에 옮겨 컴파일해 보는 것이 좋다. 실제로 무엇이 출력되는지는 컴파일한 결과만이 보여 주기 때문이다.
입력란에는 스페인어로 쓴 문서의 글만 들어 있다. 점검은 바로 이 글을 찾으므로 그대로 두어야 한다. 이것을 LuaLaTeX로 컴파일되는 완전한 문서로 만들라. 필요한 것은 article 클래스, fontspec과 babel 패키지(언어는 글의 언어인 스페인어), 그리고 본문의 시작과 끝이다. 스페인어는 로마자로 쓰므로 한글 글꼴은 필요 없다. 글은 바뀌지 않는다.
브라우저가 코드를 즉시 검사합니다. 컴파일하지도, 채점하지도 않습니다. 실제 결과를 보려면 Texmaker에서 컴파일하세요.
힌트
문서는 두 부분으로 이루어진다. 클래스로 시작하여 패키지를 불러오는 프리앰블과, 글을 담는 본문이다.
풀이 보기
\documentclass{article}\usepackage{fontspec}\usepackage[spanish]{babel}\begin{document}\section{Introducción}La composición tipográfica decide dónde cae cada letra.\end{document}스페인어 논문에서 가져온 다음 조각은 각 줄이 무엇인지가 아니라 어떻게 보여야 하는지를 말한다. 내용을 표시하도록 다시 써라. 첫째 제목은 절이고 둘째 제목은 소절이며, 둘 다 클래스가 번호를 붙인다. 그리고 “qué es”(“무엇인지”)는 강조되는 표현이다. 글은 바뀌지 않으며(점검은 스페인어 낱말을 찾는다), 강제 줄바꿈은 없어진다.
브라우저가 코드를 즉시 검사합니다. 컴파일하지도, 채점하지도 않습니다. 실제 결과를 보려면 Texmaker에서 컴파일하세요.
힌트
줄마다 그것이 무엇인지(절 제목, 소절 제목, 강조되는 표현) 스스로 물어보고, 그것을 말하는 명령을 찾아라. 나머지는 모두 클래스가 정한다.
풀이 보기
\section{Marcado y procesador de textos}En un lenguaje de marcado, el autor dice \emph{qué es} cada cosa.\subsection{El procesador de textos}El autor ve la página tal como se imprimirá.연습 문제
문제마다 힌트가 있는데, 스스로 풀어 본 뒤에 여는 것이 좋다. 또 답이 있으며, 힌트를 연 뒤에 나타난다.
다음 본문이 어떤 글을 출력할지 예측하라. 여기서 \LaTeX와 \TeX는 LaTeX와 TeX의 로고를 출력하는 명령이다. 두 줄의 차이를 설명하고, 첫 줄을 고치는 방법을 제안하라.
\LaTeX Beamer로 발표 자료를 만든다.\LaTeX{} Beamer와 \TeX\ Live를 매일 쓴다.힌트
글자로 이루어진 명령의 이름이 어디서 끝나는지, 그리고 그 바로 뒤의 공백을 엔진이 어떻게 다루는지 생각해 보라. 그 공백은 글의 일부인가, 명령의 일부인가?
정답
한 문단이 된다. “LaTeXBeamer로 발표 자료를 만든다. LaTeX Beamer와 TeX Live를 매일 쓴다.” 명령의 이름은 글자가 아닌 첫 문자에서 끝나고, 그 뒤에 오는 공백은 명령을 읽을 때 흡수된다. 둘째 줄에서는 빈 중괄호와, 공백 앞의 역슬래시가 명령을 닫고 공백을 남긴다. 첫 줄은 \LaTeX{} Beamer로 쓰거나 공백 앞에 역슬래시를 두면 고쳐진다. LuaLaTeX에서는 한글도 글자로 치므로, 공백 없이 쓴 \LaTeX로는 다른, 존재하지 않는 명령의 이름이 된다.
다음 각 문서를 특별한 준비 없이 어떤 엔진으로 컴파일할 수 있는지 판단하고 그 이유를 밝혀라. LaTeX의 기본 글꼴로 조판한 영어 수학 학위 논문. 라틴어 주가 달린 그리스어 논고의 교감본으로, 시스템에 설치된 OpenType 글꼴을 써야 하는 것. 아랍어와 힌디어 문헌을 인용하는 한국어 논문. 그런 다음 이 강좌가 모든 문서에 엔진 하나를 쓰는 이유를 설명하라.
힌트
문서마다 두 가지를 스스로 물어보라. 시스템 글꼴이 필요한가? 로마자가 아닌 문자 체계를 담고 있어서 유니코드로 읽어야 하고, 경우에 따라 글자를 잇거나 결합해야 하는가?
정답
수학 학위 논문은 세 엔진 모두로 된다. 그리스어 교감본은 시스템 글꼴과 유니코드로 된 그리스어 때문에 XeLaTeX나 LuaLaTeX가 필요하다. 아랍어와 힌디어가 든 한국어 논문도 유니코드, 한글 자체, 이어지고 결합하는 글자, 아랍어의 오른쪽에서 왼쪽으로 쓰는 방향 때문에 XeLaTeX나 LuaLaTeX가 필요하다. LuaLaTeX는 셋 모두에 쓸 수 있고, 엔진을 하나로 하면 강좌의 모든 원본을 같은 방식으로 컴파일할 수 있다.
다음 각 경우에 LaTeX와 워드프로세서 가운데 무엇이 나은지 판단하고, 습관이 아닌 기준으로 이유를 밝혀라. 관공서에 보내는 두 쪽짜리 편지. 수식, 번호 붙은 그림, 백오십 개의 참고문헌이 든 이백 쪽의 학위 논문. 워드프로세서 파일만 받고 변경 내용 추적으로 교정하는 역사학 학술지에 낼 논문. 그리스어 인용문이 들어 있고 저자가 여러 해에 걸쳐 보태 나갈 강의 노트.
힌트
각 경우에 인쇄된 결과만이 아니라, 문서의 분량과 구조, 얼마나 오래 쓰일지, 그 파일을 누가 또 읽거나 고쳐야 하는지를 생각하라.
정답
편지는 워드프로세서로 쓴다. 짧고, 구조가 없고, 이후의 수명도 없다. 학위 논문은 LaTeX로 쓴다. 그 분량, 수식, 상호 참조가 자동 번호 매기기와 데이터베이스로 관리하는 참고문헌의 덕을 본다. 논문은 워드프로세서로 쓴다. 받는 쪽이 그것을 요구하기 때문이다. 강의 노트는 LaTeX로 쓴다. 긴 수명, 자라나는 구조, 그리스어가 일반 텍스트와 유니코드에 유리하게 작용한다.