

 Español
 English
 Português
 العربية
 हिन्दी
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 日本語
 한국어
 Latine
摘要
本课说明 LaTeX 是什么,以及学术界为什么使用它。本课从排版谈起,即安排每一个字、每一行和每一页的技艺,以及学术文本的特殊要求;公允地比较标记语言与文字处理软件;讲述 Donald Knuth(高德纳)为什么创造 TeX,Leslie Lamport 又如何在其上构建 LaTeX,其原则是把内容与形式分开;区分今天用来编译的三种引擎 pdfLaTeX、XeLaTeX 和 LuaLaTeX,并说明本课程选择 LuaLaTeX 的理由;展示源文件的样子以及它如何变成 PDF 文档;概览它在各学科中的应用,从数学和物理学到哲学和语文学;最后讲它的局限,以便知道什么时候用文字处理软件就够了。
学习目标
- 解释什么是排版,以及为什么学术文本比其他文本更需要它。
- 比较标记语言与文字处理软件,指出各自的长处和代价。
- 区分 TeX 与 LaTeX,并举例说明把内容与形式分开意味着什么。
- 根据文档的语言、文字系统和字体,为它选择合适的引擎。
- 注意空格、段落和注释,预测一段简短的源代码会产生什么。
排版
每一篇印出来或在屏幕上阅读的文本都经过了排版:有人或有某种东西决定了每个字落在哪个确切的位置。排版就是这些决定的总和:用什么字体和字号,每一行在哪里结束,西文行内的词间空白如何分配才能使各行左右对齐,哪些词在行末断开、从哪里断开,两个字母何时合成连字,某些字母对之间的距离如何调整,每一页在哪里分页,注释放在什么高度,标题如何安排。几个世纪以来,这是排字工人的手艺,他们用金属活字拼成一行行文字;今天由程序来执行,但要做的决定仍然相同。
好的段落不引人注意:目光沿着各行移动,不会被参差的空隙或荒唐的断词绊住。然而做到这一点并不简单,因为每一个决定都制约着后面的决定:第一行在哪里结束,决定了第二行从哪个词开始,如此一直到段落结束。
一种简单的方法是在每一行里尽量放入能容纳的词,然后转到下一行,从不回头。如果一个长词放不进第三行的末尾,这一行的词与词之间就会留下很大的空白,尽管只要把第二行的一个短词挪过去就能避免。Knuth 和 Michael Plass 为 TeX 设计的方法则不同:它同时考虑段落所有可能的断行位置,选出在整体上最能均匀分配空白的组合。由此可知,某一行可能比它本可以容纳的稍微空一些,只要后面的各行因此变得更好。这一方法针对的是以空格分词的西文;中文段落的断行和标点处理另有规则,同样由排版程序依规则完成。
学术文本比其他文本更需要这种用心。它们包含公式,而公式的排版遵循自己的规则(等号周围的间距不同于逗号周围的间距,下标按一定比例缩小);它们不断引用自身,带有按编号引用的章节、定理、图和公式;它们积累了大量脚注和参考文献,必须遵循统一的格式;它们常常混用多种语言和多种文字;而且通常篇幅很长,在一百页里反复出现的疏忽无法靠手工改正。如果是这样,就应当把排版交给一个用明确规则来处理它的系统,让作者专心于自己要说的内容。
标记语言与文字处理软件
让程序排版一段文本有两种方式。在文字处理软件中,例如 Microsoft Word 或 LibreOffice Writer,作者在屏幕上看到的就是将要打印出来的页面,并直接修改它:选中一个词把它设为斜体,拖动页边距,给标题选更大的字号。这种方式通常用英语短语 what you see is what you get(所见即所得)来描述。
而在标记语言中,作者写的是一个纯文本文件,在其中插入标记,说明每样东西是什么或应当如何处理:某个词需要强调,某一行是一节的标题,某一段是引文。随后由程序读取这个文件,生成排好版的文档。网页就是这样用 HTML 写成的;LaTeX 则是一种为生成高质量印刷文档而设计的标记语言。
要做到公允,比较就必须承认每种方式各自的长处。文字处理软件能即时反馈,几乎不需要预先学习,是大多数合作者都熟悉的工具,它的修订跟踪功能也是许多出版社和办公室常用的审稿手段。标记语言则提供:任何程序在四十年后仍能打开的纯文本文件,它们占用空间小,各个版本可以逐行比较;明确的结构,目录、编号和交叉引用都由此自动生成;不依赖于作者自律的统一性;以及文字处理软件达不到的公式和段落排版质量。它的代价同样明显:必须学习标记,编译之前看不到结果,一个输入错误就可能使编译中断。
TeX 与 LaTeX
Donald Knuth 与 TeX
Donald Knuth(高德纳)是斯坦福大学的计算机科学教授,从 1968 年起陆续出版《计算机程序设计艺术》(The Art of Computer Programming)各卷。1977 年前后,他收到第二卷新版的校样,这些校样是用取代了金属活字的照相排版技术排出来的,他认为其质量远不如第一版,尤其是公式部分。他没有将就,而是决定亲自编写一个排版程序,让数学书恢复最优秀的传统印刷品质,并且在任何计算机上都输出完全相同的结果。TeX 的第一个版本于 1978 年问世;在下一个十年之初,Knuth 把它彻底重写,还设计了 METAFONT 程序,并用它绘制了 Computer Modern 字体。
这个名字来自希腊语:它的字母是大写的 tau、epsilon 和 chi,即希腊词 τέχνη 的开头,这个词兼有艺术与技术之意,因此最后一个字母不读作英语的 x,而接近汉语拼音的 h,读如“泰赫”。Knuth 已宣布 TeX 定型,只接受错误修正:从第 3 版起,版本号逐步逼近 π,每修正一次就多添一位数字。这种稳定性是它的优点之一,因为几十年前写成的文档今天编译出来的结果仍然相同。
然而 TeX 是一种低层语言:它的原始命令讲的是盒子、可伸缩的空白,以及在这里或那里断行所受的罚分。对一个只想写一篇文章的作者来说,用这些术语去编写每一个标题和每一条注释,负担未免过重。因此 TeX 允许定义宏,即展开为更基本的命令的新命令,而它几乎所有的实际使用都要通过宏集来进行。
Leslie Lamport 与 LaTeX:内容与形式分离
20 世纪 80 年代初,以分布式系统研究闻名的计算机科学家 Leslie Lamport 在 TeX 之上编写了一套宏集,命名为 LaTeX,其第一个版本于 1984 年流传开来;1986 年,他出版了手册 LaTeX: A Document Preparation System。自 1994 年起,现行版本 LaTeX2e 由一个志愿者团队 LaTeX Project 维护。
LaTeX 的核心思想是:作者标记的是内容,而不是形式。他不写“这一行用粗体、较大字号”,而写“这是一节的标题”,用 \section{结果};不写“这个词用斜体”,而写“这个词需要强调”,用 \emph{假设}。一节的标题是什么样子,带不带编号,与正文相隔多远,都由开头声明的文档类以及作者在导言区加入的命令来决定。由此可知,整篇文档的样式只需在一处修改,同一份文本也可以按照两家不同期刊的规范排版,而无需改动正文的任何一行。
下面的源代码中没有任何关于字号、字体或编号的指示:只说明每一行是什么。节和小节的编号、它们标题的大小和粗细,以及强调词的样式,都由文档类决定。汉字没有斜体,所以这里强调的是括号中的西文术语,它按西文的惯例以斜体排出;中文的强调样式需要另行设定。
\section{结果}数据证实了最初的假设(\emph{hypothesis})。\subsection{样本}样本包括三位作者的十二篇文本。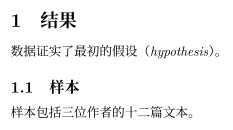
如果以后在这一节之前插入新的一节,它的编号会自动从一变成二,小节以及所有引用它们的地方也会随之改变。
引擎:pdfLaTeX、XeLaTeX 与 LuaLaTeX
LaTeX 是一组宏,而不是程序:它需要一个引擎,即 TeX 家族中执行这些宏并生成文档的程序。今天使用的引擎有三种,它们都理解同一种 LaTeX;区别在于读取文本的方式以及能够使用的字体。
- pdfLaTeX 使用 pdfTeX 引擎,由 Hàn Thế Thành 开发,用来直接生成 PDF 文件。它速度快、使用广泛,是 Overleaf 的默认引擎。但它的字体是 TeX 经典格式的字体,每种最多 256 个字符,因此不能直接加载系统中安装的字体,书写希腊文、西里尔文、中文或其他文字都需要特殊的编码和宏包;没有它们,一个希腊字母就会让编译报错中断。
- XeLaTeX 使用 Jonathan Kew 创建的 XeTeX 引擎,它以 Unicode 读取文本,Unicode 是为所有文字的每个字符分配一个编号的标准;它还能通过 fontspec 宏包加载系统中的任何 OpenType 字体。
- LuaLaTeX 使用 LuaTeX 引擎,它在 Unicode 和字体方面提供与 XeTeX 相同的功能,另外还内嵌了 Lua 编程语言,宏包可以借助它介入排版过程。当前的发行版以 HarfBuzz 库来运行它,这个库负责为字母相连或组合的文字塑形,例如阿拉伯文和天城文。
本课程使用 LuaLaTeX。理由来自上文:它直接以 Unicode 书写,因此带有重音和气符的多调希腊文柏拉图引文可以原样键入;它使用系统字体,包括大学或期刊要求的字体;它能在同一文档中排版中文、希腊文和拉丁文,每种语言各按自己的规则处理;借助合适的宏包,它还支持从右向左书写的文字,如阿拉伯文,以及词与词之间不用空格分隔的文字,如中文和日文。中文排版常用的 ctex 宏包集在 LuaLaTeX 下同样可用。因此,一个引擎就足以满足一门同时面向理科和人文学科的课程的全部文档。与 pdfLaTeX 相比,它唯一的代价是编译稍慢,在一般篇幅的文档中几乎察觉不到。
下面的源代码加载 luatexja-fontspec 来排中文,并分别为汉字和西文选定字体;第三行让 luatexja 把希腊字母当作西文字符处理,否则它会到汉字字体中去找这些字母,而那里没有多调希腊文。随后,babel 把中文声明为主要语言,把古希腊语和拉丁语声明为次要语言;其中 \babeladjust 一行让中文标点保持全角宽度,讲语言的一课会解释它。希腊词直接用它们的字符书写。
\documentclass{article}\usepackage{luatexja-fontspec}\ltjsetparameter{jacharrange={-2}}\setmainjfont{Noto Serif CJK SC}\setmainfont{Linux Libertine O}\usepackage{babel}\babelprovide[import,main]{chinese}\babeladjust{linebreak.cjk=off}\babelprovide[import]{ancientgreek}\babelprovide[import]{latin}\begin{document}亚里士多德以这样一句话开始《形而上学》:\foreignlanguage{ancientgreek}{πάντες ἄνθρωποι τοῦ εἰδέναι ὀρέγονται φύσει.}拉丁传统是这样传述它的:\foreignlanguage{latin}{omnes homines natura scire desiderant.}\end{document}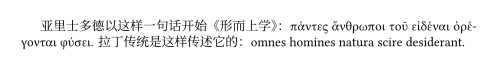
用 \foreignlanguage 标记一段文字并不改变字母的外观:它指明这段文字是哪种语言,以便应用该语言的断词规则和惯例。用 pdfLaTeX 编译,这份源代码将无法通过:fontspec(luatexja-fontspec 以它为基础)要求 XeLaTeX 或 LuaLaTeX。
源文件、编译与 PDF
LaTeX 文档是扩展名为 .tex 的纯文本文件,由两部分组成。导言区从第一行 \documentclass{article} 开始,这一行声明文档类,一直到 \begin{document} 为止;在导言区里用 \usepackage 加载宏包,并确定有关形式的各项决定。正文从 \begin{document} 到 \end{document},包含文本。命令以反斜杠开头,命令接收的内容写在花括号里。
这份源代码是一个完整的文档:无需添加任何东西就能编译,也将是本课程各文档的出发点。
\documentclass{article}\usepackage{luatexja-fontspec}\setmainjfont{Noto Serif CJK SC}\begin{document}\section{引言}排版决定每个字落在哪里。\end{document}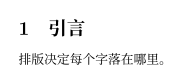
这一节没有写编号,却得到了编号一,标题使用 article 类所规定的字体和字号。第二、三行用于中文:luatexja-fontspec 宏包在 fontspec 的基础上加入汉字排版,\setmainjfont 选择一种含有汉字的字体(这里是 Noto Serif CJK SC),因为默认字体(Latin Modern)不含汉字。中文用户也常用 ctex 宏包集提供的文档类(例如 ctexart),它在 LuaLaTeX 下完成同样的设置。
工作循环分三步:写源代码,编译,阅读结果。编译就是让引擎处理文件,在本课程中用的是命令 lualatex,它读取源代码并写出同名的 PDF 文件。旁边还会留下一些辅助文件,其中扩展名为 .log 的是日志文件,引擎在其中记录错误和警告;扩展名为 .aux 的文件则保存各节和各页的编号。因此,目录或交叉引用要在第二次编译之后才能正确显示:第一次编译时,引擎记下每样东西落在哪里;第二次编译时才加以利用。实际上不必手工输入命令:编辑器按一个按钮就会执行。本课程在自己的计算机上使用 Texmaker,或在浏览器中使用 Overleaf;下一课将准备好这个环境。
源代码并不是按书写的样子排版的,三条规则可以解释初学者遇到的大多数意外。第一,连续的多个空格等于一个;在西文中,换行也等于一个空格,因为空白由引擎自行分配,作者打出的空格只表示一个词在此结束。两个汉字之间的换行则不产生空格:luatexja 会把它去掉(ctex 也是如此),所以中文段落可以在任意位置换行;但在汉字之间打出的空格仍会印成一个空格。第二,一个或多个空行结束当前段落并开始新的段落。第三,符号 % 开始一条注释:引擎忽略它之后直到行末的一切,包括换行本身。
下面的源代码是故意写得很随意的。结果是两个空白均匀的段落,注释符号后面的说明不会出现。
重复的空格 只算一个; 行首的空格被忽略,汉字之间的换行也不产生空格。空行开始一个新段落。% 这条说明不会印出。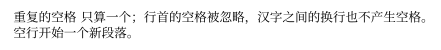
既然如此,要印出百分号,光写它是不够的:必须在它前面加一个反斜杠,写成 \%。LaTeX 为自身功能保留的其他字符也是一样,例如花括号或美元符号。
LaTeX 在各学科中的应用
在数学、物理学和计算机科学的很大一部分领域,LaTeX 是通行标准:期刊提供自己的文档类,让作者按期刊格式提交论文;arXiv 是这些学科的论文在正式发表前发布的预印本库,它接收 LaTeX 源文件并自行编译。原因在于公式排版,没有其他系统能以如此小的代价达到同样的效果,此外还有定理和公式的自动编号。经济学、统计学、工程学和化学也大量使用它。
然而,以为 LaTeX 只是精确科学的事,那就错了。在哲学、古典语文学和历史学中,它的长处不同,但并不逊色。校勘本在古代文本旁附有校勘记,在按行号编排的注释中记录各写本的异文;LaTeX 为此提供了专门的宏包,例如 reledmac,它能给各行编号,安排多层注释,并在文本改动时保持其引用。多调希腊文和拉丁文都能正确书写和断词,前面已经看到。人文学科论文中可能多达数百条的脚注,会自动编号并放在所在页上。至于参考文献,借助 BibLaTeX 只需作为数据库写一次,就能按所要求的任何格式引用,无论是社会科学的著者-出版年制、理科的顺序编码制,还是人文学科的脚注制,只需更改一个选项。
LaTeX 的局限
不过,LaTeX 也有实实在在的代价,采用之前最好了解清楚。它的学习曲线很陡:最初几周需要经常查找,在文字处理软件里点一下就能完成的事该怎么做。它的错误信息继承自 TeX,往往晦涩难懂,有时指向的行还在真正出错的行之后;本单元稍后的一课会教大家如何阅读它们。自由设计的版面,例如海报或图文杂志,每个元素都要手工放置,用 LaTeX 做比用排版设计软件更费力。而且并非所有接收方都接受它:不少人文学科期刊、出版社和办公室要求提交文字处理软件的文件,并用其中的修订跟踪功能审稿。
由此得出一个简单的标准。一封短信、一份会议记录、一张表格,或者一份将由他人在文字处理软件中修改的文本,最好用文字处理软件来写。一份篇幅长、有结构、有公式、有引文和注释、涉及多种语言,或者前面还有很长寿命、要在多年里不断修改和再版的文档,最好用 LaTeX 来写。
例题
下面的题目不是要求复述前面讲过的内容,而是要求运用它:第一题要求准确预测一段源代码会产生什么,第二题要求判断一份文档需要什么引擎和字体,第三题要求在一段没有注意这一点的源代码中把内容与形式分开。
不编译,准确预测下面的正文产生什么文本、有几个段落,以及每个百分号会怎样。
在 LaTeX 中,排版 决定每个字落在哪里。好的段落不会引人注意。有 50 % 的读者察觉不到差别。引擎名 Lua%LaTeX 连成一个词。解答
前三行之间没有空行:它们构成一个段落。LaTeX 后面重复的空格合为一个,第二行行首的空格被忽略。第一行以汉字“版”结尾,第二行以“。”结尾,汉字之间的换行不产生空格。第一段是:“在 LaTeX 中,排版决定每个字落在哪里。好的段落不会引人注意。”
接着是两个空行。一个空行就足以结束段落,第二个不再增加任何东西:既没有空段落,也没有更大的间距。于是开始第二段。
在
有 50 % 的读者这一行中,百分号不会印出:它开始一条注释。引擎丢弃“的读者”以及换行;只剩下百分号前面打出的那个空格,下一行从那里接上。在 “Lua” 处,百分号紧贴着西文词:它去掉换行而不留下任何空格,引擎还会略去下一行行首的空格。由此可知,“Lua”和“LaTeX”连成一个词。
第二段是:“有 50 察觉不到差别。引擎名 LuaLaTeX 连成一个词。”作者本想写一个百分比,结果丢了半句话,而引擎没有报告任何错误;要印出百分号,应当写
\%。
一位哲学专业的学生正在用中文写一篇关于《斐多篇》的学位论文。她引用柏拉图的多调希腊文原文和拉丁注释家的段落,她的大学要求使用某种规定的字体,这种字体以 OpenType 文件的形式安装在她的计算机上,其中不含希腊字母。判断她需要什么引擎,以及为了让文档完整输出,她还必须声明什么。
解答
pdfLaTeX 因两个互不相干的原因而被排除:它不能直接加载系统中的 OpenType 字体;而且如果不准备特殊的编码和字体,用 Unicode 写的希腊字母会使它的编译中断。仅第一个原因就足以排除它,因为学校规定的字体是必须使用的。
XeLaTeX 和 LuaLaTeX 都读取 Unicode,并通过 fontspec 加载系统字体:用其中任何一个,都可以在导言区声明学校规定的字体,西文字体用
\setmainfont,汉字字体用\setmainjfont。本课程使用 LuaLaTeX。但光有引擎还不够。如果字体中没有希腊字母,LuaLaTeX 编译时不会报错,但希腊词不会出现在 PDF 中:引擎只在日志文件里记下
Missing character之类的警告。问题在编译时看不出来,要在阅读结果时才会发现。因此,必须为希腊文另外指定一种含有希腊字母的字体。借助 babel,用
\babelprovide[import]{ancientgreek}把古希腊语声明为一种语言,再用\babelfont[ancientgreek]{rm}{GFS Didot}为它指定字体;每段希腊文都用\foreignlanguage标记。中文文档还需像前面的例子那样,让 luatexja 把希腊字母当作西文字符。拉丁文用拉丁字母书写,学校规定的字体中有这些字母;它不需要别的字体,只需用 babel 的
\babelprovide[import]{latin}声明为一种语言,使它的词按拉丁语而不是英语的规则断开。总之:LuaLaTeX,学校规定的字体作为主字体,为希腊文段落准备一种含多调希腊文的字体,并把中文、古希腊语和拉丁语声明为语言。
一位作者这样写了一篇文章第二节的开头。指出哪些标记表达的是形式而不是内容,把它们改写成只说明每样东西是什么,并说明如果期刊日后要求希腊术语不用斜体,这样做有什么好处。
{\Large\bfseries 2. 结果}\\[6pt]正如亚里士多德在 \textit{Metaphysica} 中所说,求知的欲望是\textit{自然的};希腊语术语是 \textit{φύσει}。\\\vspace{12pt}{\large\bfseries 2.1. 样本}\\解答
第一行用手工设定了字号、粗细、编号和间距,而它实际上是一节的标题。应当换成
\section{结果},编号由文档类给出;手写的编号在前面插入一节之后就会出错。在这段源代码中,
\textit出现了三次,承担三种不同的功能:标记一部作品的标题、一个强调的词和一个希腊术语。三者今天都印成斜体,只是形式上的巧合,而不是内容上的同一;况且汉字没有斜体,“自然的”实际上根本不会显出强调。每种功能都应有自己的标记。强调的词有
\emph{自然的};另外两种则在导言区定义新命令,例如\newcommand{\zuopin}[1]{\textit{#1}}以及类似的\shuyu,在正文中写作\zuopin{Metaphysica}和\shuyu{φύσει}。中文强调的样式也可以在导言区另行定义,例如改用着重号或黑体。强制换行的双反斜杠和手工加入的垂直间距是在模仿段落之间的分隔。应当删去:用空行结束段落,间距由文档类决定。小节标题写作
\subsection{样本}。如果期刊要求希腊术语不用斜体,只需修改导言区的一行,即定义
\shuyu的那一行,这一改动就会作用于文章中的所有术语,而不会触及作品标题和强调的词。若用原来的源代码,就得逐一检查所有斜体,并在每一处判断它对应哪种功能。
在线练习
在这些练习中,把代码写进输入框,浏览器会立即检查:检查花括号、环境以及每道练习的要求,但不编译代码。通过检查后,最好把代码复制到 Texmaker 中编译,因为只有编译出的结果才能显示实际印出的内容。
输入框里只有一份西班牙语文档的文本;检查程序要找的正是这段文本,所以要原样保留。把它补全为一份能用 LuaLaTeX 编译的完整文档:article 文档类,fontspec 和 babel 宏包,babel 的语言选用文本所用的西班牙语,以及正文的开头和结尾。西班牙语用拉丁字母书写,因此不需要汉字字体。文本不变。
浏览器会立即检查你的代码,既不编译,也不评分。要看到真实的结果,请在 Texmaker 中编译。
提示
一份文档由两部分组成:导言区以文档类开头并加载宏包,正文包含文本。
查看解答
\documentclass{article}\usepackage{fontspec}\usepackage[spanish]{babel}\begin{document}\section{Introducción}La composición tipográfica decide dónde cae cada letra.\end{document}下面这段取自一篇西班牙语文章的片段,说的是每一行应该是什么样子,而不是它是什么。把它改写成标记内容的形式:第一个标题是一节,第二个是一小节,二者都由文档类编号,而“qué es”(“是什么”)是一个需要强调的短语。文本不变(检查程序要找的是西班牙语原文),强制换行要去掉。
浏览器会立即检查你的代码,既不编译,也不评分。要看到真实的结果,请在 Texmaker 中编译。
提示
对每一行都问一问它是什么(节标题、小节标题,还是需要强调的短语),再找出表达这一点的命令;其余的一切都由文档类决定。
查看解答
\section{Marcado y procesador de textos}En un lenguaje de marcado, el autor dice \emph{qué es} cada cosa.\subsection{El procesador de textos}El autor ve la página tal como se imprimirá.习题
每道题都有一条提示,最好在自己尝试之后再打开;还有一个答案,打开提示后才会出现。
预测下面的正文会产生什么文本,其中 \LaTeX 和 \TeX 是印出 LaTeX 和 TeX 标志的命令。解释两行之间的差别,并为第一行提出改正方法。
我用 \LaTeX Beamer 制作幻灯片。我也用 \LaTeX{} Beamer 和 \TeX\ Live。提示
想一想:由字母组成的命令名在哪里结束?引擎如何处理紧跟在命令名后面的空格:它属于文本,还是属于命令?
答案
一个段落:“我用 LaTeXBeamer 制作幻灯片。我也用 LaTeX Beamer 和 TeX Live。”命令名在第一个不是字母的字符处结束,紧跟其后的空格在读取命令时被吞掉;第二行中,空花括号以及后跟空格的反斜杠结束了命令并保留了空格。第一行可以改为 \LaTeX{} Beamer,或者用后跟空格的反斜杠。这个例子特意让命令后面跟着西文词:如果后面是汉字,luatexja 会在西文与汉字之间自动加入间距,丢失的空格就看不出来了。注意在 LuaLaTeX 中汉字也算字母,所以 \LaTeX制作 这样不加空格的写法会成为另一个并不存在的命令名。
对下面每一份文档,判断它可以不经特殊准备而用哪些引擎编译,并说明理由:一篇用 LaTeX 默认字体排版的英文数学论文;一部附有拉丁文注释的希腊文论著的校勘本,必须使用系统中安装的一种 OpenType 字体;一篇引用阿拉伯文和印地文文献的中文文章。然后解释本课程为什么对所有文档只采用一种引擎。
提示
对每份文档问自己两个问题:它是否需要系统字体;它是否包含拉丁字母以外的文字,这些文字需要以 Unicode 读取,并且在某些情况下字母要相连或组合。
答案
数学论文三种引擎都可以用。希腊文校勘本需要 XeLaTeX 或 LuaLaTeX,因为要用系统字体,还因为希腊文是 Unicode 文本。含阿拉伯文和印地文的中文文章同样需要 XeLaTeX 或 LuaLaTeX,因为 Unicode,因为汉字本身,因为要相连和组合的字母,还因为阿拉伯文从右向左书写。LuaLaTeX 对三者都适用,而只用一种引擎,课程中的所有源代码都以同样的方式编译。
对下面每种情况,判断用 LaTeX 还是文字处理软件更合适,并用习惯以外的标准说明理由:一封寄给某个办公室的两页信件;一篇两百页、含公式、带编号的图和一百五十条参考文献的学位论文;一篇投给历史期刊的文章,该刊只接受文字处理软件的文件并用修订跟踪功能审稿;一份含希腊文引文的课堂讲义,作者将在多年里不断扩充。
提示
在每种情况下,考虑文档的篇幅和结构、它的寿命有多长、还有谁需要阅读或修改它的文件,而不只是印出来的结果。
答案
信件用文字处理软件:它很短,没有结构,也没有后续的生命。学位论文用 LaTeX:它的篇幅、公式和交叉引用都得益于自动编号和以数据库形式管理的参考文献。文章用文字处理软件,因为接收方有此要求。讲义用 LaTeX:它的寿命长、结构不断增长,又含希腊文,这些都有利于纯文本和 Unicode。
已完成
登录账户以保存您的进度