

 Español
 English
 Português
 中文 (中国)
 العربية
 हिन्दी
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 한국어
 Latine
要約
この回では、LaTeX とは何か、そして学術の世界がなぜそれを使うのかを説明する。一つ一つの文字、行、ページを配置する技である組版と、学術文書に特有の要求から出発する。マークアップ言語とワープロを公平に比べる。Donald Knuth がなぜ TeX を作り、Leslie Lamport がその上にどのように LaTeX を築いたかを語る。LaTeX の原理は内容を形式から切り離すことである。今日コンパイルに使われる三つのエンジン、pdfLaTeX、XeLaTeX、LuaLaTeX を区別し、この講座で LuaLaTeX を選ぶ理由を示す。ソースファイルがどのようなもので、どのように PDF 文書になるかを示す。数学や物理学から哲学や文献学まで、諸分野での使われ方を見渡す。最後にその限界を述べ、ワープロで足りるのはどのような場合かを明らかにする。
学習目標
- 組版とは何か、また学術文書がなぜ他の文書以上にそれを必要とするのかを説明する。
- マークアップ言語とワープロを比較し、それぞれの利点と代償を指摘する。
- TeX と LaTeX を区別し、内容を形式から切り離すとはどういうことかを例を挙げて説明する。
- 文書の言語、文字体系、書体に応じて、適切なエンジンを選ぶ。
- 空白、段落、コメントに注意して、短いソースが何を出力するかを予測する。
組版
印刷された文章も画面で読む文章も、すべて組版されている。誰かが、あるいは何かが、それぞれの文字がどこに置かれるかを正確に決めたのである。組版とは、こうした決定の総体である。どの書体をどの大きさで使うか、各行をどこで終え、行を揃えるために欧文の語間をどう配分するか、どの語を行末でハイフンで分割し、どこで切るか、二つの文字をいつ合字にするか、特定の文字の組の間隔をどう詰めるか(カーニング)、各ページをどこで改めるか、注をどの高さに置くか、見出しをどう配列するか。何世紀ものあいだ、これは金属活字で行を組む植字工の仕事であった。今日ではプログラムがそれを実行するが、決めるべきことは変わらない。
よい段落は目立たない。目は、不揃いな空きや不自然な分割につまずくことなく行をたどっていく。しかし、これを実現するのは容易ではない。一つの決定がその後の決定を左右するからである。一行目がどこで終わるかによって二行目がどの語で始まるかが決まり、それが段落の終わりまで続く。
単純な方法は、各行に入るだけの語を詰め込んで次の行に移り、決して後戻りしない。長い語が三行目の末尾に収まらないと、その行の語間は大きく空いてしまう。二行目から短い語を一つ移せば避けられたにもかかわらずである。Knuth と Michael Plass が TeX のために考案した方法は異なる。段落のあらゆる改行位置の候補を同時に検討し、全体として空白を最もよく配分する組み合わせを選ぶのである。したがって、後続の行がよくなるのであれば、ある行は詰められるはずの量より少し空いたまま残ることがある。この方法は語を空白で区切る欧文を対象としたものであり、和文の行分割や約物の処理には独自の規則があって、それも組版プログラムが規則に従って行う。
学術文書は、他の文書以上にこうした配慮を必要とする。学術文書には数式が含まれ、その組版には固有の規則がある(等号のまわりの空きは読点や欧文コンマのまわりの空きとは違い、下付き文字は決まった比率で縮小される)。また、番号付きの節、定理、図、数式を番号で引用しながら、絶えず自分自身を参照する。脚注や参考文献が積み重なり、それらは統一された様式に従わなければならない。複数の言語や文字体系が混じることも多い。そして概して長いので、百ページにわたって繰り返された不注意を手作業で直すことはできない。そうであるならば、組版は明示的な規則でそれを解決するシステムに任せ、著者は自分の述べる内容に専念するのがよい。
マークアップとワープロ
プログラムに文章を組ませる方法は二つある。Microsoft Word や LibreOffice Writer のようなワープロでは、著者は印刷されるとおりのページを画面で見ながら、それを直接変更する。語を選んでイタリックにし、余白をドラッグし、見出しにより大きな文字サイズを選ぶ。この方式は、英語の what you see is what you get(見たままが得られる)という言い回しでよく説明される。
これに対してマークアップ言語では、著者はプレーンテキストのファイルを書き、そこに、それぞれのものが何であるか、どう扱うべきかを示す印を挟み込む。この語は強調される、この行は節の見出しである、この箇所は引用である、といった具合である。その後、プログラムがこのファイルを読み、組版された文書を作る。ウェブページはこのように HTML で書かれる。LaTeX は、質の高い印刷文書を作るために設計されたマークアップ言語である。
比較を公平にするには、それぞれの方式が何を得意とするかを認めなければならない。ワープロはすぐに結果が見え、事前の学習をほとんど必要とせず、共同作業の相手の大半が知っている道具であり、その変更履歴の機能は多くの出版社や職場で校閲の標準的な手段になっている。一方、マークアップ言語が提供するのは次のものである。四十年後でもどんなプログラムでも開けるプレーンテキストのファイル。これは容量が小さく、版どうしを一行ずつ比較できる。明示的な構造。目次、番号付け、相互参照はそこから自動的に生まれる。著者の几帳面さに左右されない統一性。そして、ワープロには及ばない水準の数式と段落の組版。その代償も同じくらい明らかである。印を覚えなければならず、コンパイルするまで結果は見えず、入力の誤り一つでコンパイルが止まることもある。
TeX と LaTeX
Donald Knuth と TeX
スタンフォード大学の計算機科学の教授 Donald Knuth は、1968 年から The Art of Computer Programming の各巻を刊行していた。1977 年ごろ、第 2 巻の新版の校正刷りを受け取ったとき、それは金属活字に取って代わった写真植字で組まれていたが、彼はそれが初版のものよりはるかに劣ると判断した。とりわけ数式がそうであった。彼は甘んじることなく、数学書に最良の伝統的な活版印刷の品質を取り戻し、どのコンピュータでも同じ出力が得られる組版プログラムを自ら書くことにした。TeX の最初の版は 1978 年に現れた。Knuth は次の十年の初めにこれを全面的に書き直し、さらに METAFONT というプログラムを設計して、それで Computer Modern 書体を描いた。
名前はギリシア語に由来する。その文字は大文字のタウ、イプシロン、カイであり、技芸と技術の両方を意味する語 τέχνη の書き出しである。そのため最後の文字は英語の x ではなく、ドイツ語の「ach」の ch のように発音し、日本語では「テック」や「テフ」と呼ばれる。Knuth は TeX を完成したものと宣言し、誤りの修正しか受け付けていない。版 3 以降、版番号は π に近づいていき、修正のたびに桁が一つ増える。この安定性は TeX の美点の一つである。何十年も前に書かれた文書が、今日でも同じ結果でコンパイルできるからである。
しかし、TeX は低水準の言語である。その基本命令は、ボックス、伸縮する空白、行をあちこちで切ることに対するペナルティについて語る。論文を一本書きたいだけの著者にとって、見出しや注の一つ一つをこうした用語でプログラムするのは過大な負担である。そこで TeX はマクロ、すなわちより基本的な命令に展開される新しい命令を定義することを許しており、実際の利用のほとんどはマクロ集を通じて行われる。
Leslie Lamport と LaTeX:形式から切り離された内容
1980 年代の初め、分散システムの研究で特に知られる計算機科学者 Leslie Lamport が、TeX の上にマクロ集を書き、LaTeX と名づけた。最初の版は 1984 年に出回り、1986 年には手引書 LaTeX: A Document Preparation System を出版した。1994 年からは、LaTeX2e と呼ばれる現行版を、ボランティアのチームである LaTeX Project が保守している。
LaTeX の中心にある考えは、著者は形式ではなく内容に印をつける、というものである。「この行は太字で大きめの文字に」とは書かず、「これは節の見出しである」と \section{結果} で書く。「この語はイタリックに」とは書かず、「この語は強調される」と \emph{仮説} で書く。節の見出しがどのような見た目になるか、番号がつくか、本文からどれだけ離れるかは、冒頭で宣言される文書のクラスと、著者がプリアンブルに加える命令によって決まる。したがって、文書全体の見た目は一か所で変えられ、同じ文章を、本文の一行にも手を触れずに、二つの異なる学術誌の規定に従って組むことができる。
次のソースには、大きさ、書体、番号の指示が一つもない。それぞれの行が何であるかを述べているだけである。節と小節の番号、見出しの大きさと太さ、強調語の見た目は、ドキュメントクラスが決める。和文には既定のイタリックが効かないので、ここでは括弧内の欧文の用語を強調し、それが欧文の慣習どおりイタリックで組まれる。和文の強調の見せ方は別に設定する。
\section{結果}データは当初の仮説(\emph{hypothesis})を裏づける。\subsection{標本}標本は三人の著者による十二のテキストからなる。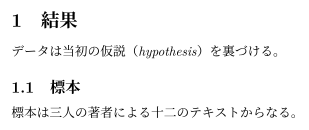
後でこの節の前に別の節を挿入すれば、この節の番号はひとりでに 1 から 2 に変わり、小節やそれらを参照するすべての箇所も同様に変わる。
エンジン:pdfLaTeX、XeLaTeX、LuaLaTeX
LaTeX はマクロの集まりであって、プログラムではない。それを実行して文書を作り出す TeX 系のプログラム、すなわちエンジンが必要である。今日使われているのは三つで、三つとも同じ LaTeX を理解する。違いは、テキストの読み方と、使える書体にある。
- pdfLaTeX は pdfTeX エンジンを使う。これは Hàn Thế Thành が PDF ファイルを直接作るために開発したものである。高速で広く普及しており、Overleaf の既定のエンジンでもある。しかし、その書体は TeX の古典的な形式のもので、一つの書体に最大 256 文字しか含められないため、システムにインストールされた書体を直接読み込めない。ギリシア文字、キリル文字、日本語などを書くには特別なエンコーディングやパッケージが必要であり、それがなければギリシア文字一つでコンパイルがエラーで止まる。
- XeLaTeX は Jonathan Kew が作った XeTeX エンジンを使う。これはテキストを、あらゆる文字体系のすべての文字に番号を割り当てる規格である Unicode で読み、fontspec パッケージを通じてシステムの任意の OpenType 書体を読み込む。
- LuaLaTeX は LuaTeX エンジンを使う。Unicode と書体については XeTeX と同じ機能を備え、さらにプログラミング言語 Lua を組み込んでおり、パッケージはそれを使って組版に介入できる。現在のディストリビューションでは HarfBuzz ライブラリとともに動作し、このライブラリが、アラビア文字やデーヴァナーガリーのように文字が連結したり結合したりする文字体系の字形を整える。
この講座では LuaLaTeX を使う。理由はこれまでの話から導かれる。Unicode で直接書けるので、アクセントや気息記号のついた多調ギリシア語のプラトンの引用もそのまま入力できる。大学や学術誌が指定する書体を含め、システムの書体が使える。日本語、ギリシア語、ラテン語を一つの文書の中で、それぞれの規則に従って組める。そして適切なパッケージを用いれば、アラビア語のように右から左へ書く文字体系や、中国語や日本語のように語を空白で区切らない文字体系も扱える。日本語の組版で広く使われる luatexja も LuaLaTeX のためのパッケージである。したがって、理系と人文系の両方に向けた講座のすべての文書に、エンジン一つで足りる。pdfLaTeX と比べた唯一の代償はコンパイルがやや遅いことだが、普通の長さの文書ではほとんど気にならない。
次のソースは、日本語を組むために luatexja-fontspec を読み込み、和文と欧文の書体をそれぞれ選ぶ。3 行目は、luatexja にギリシア文字を欧文文字として扱わせる設定である。これがないと、luatexja はギリシア文字を和文書体から取ろうとするが、そこには多調ギリシア文字がない。さらに babel によって、日本語を主言語、古典ギリシア語とラテン語を副言語として宣言する。\babeladjust の行は和文の句読点や括弧を全角の幅に保つためのもので、言語を扱う課で説明する。ギリシア語の語はその文字で直接書く。
\documentclass{article}\usepackage{luatexja-fontspec}\ltjsetparameter{jacharrange={-2}}\setmainjfont{Noto Serif CJK JP}\setmainfont{Linux Libertine O}\usepackage{babel}\babelprovide[import,main]{japanese}\babeladjust{linebreak.cjk=off}\babelprovide[import]{ancientgreek}\babelprovide[import]{latin}\begin{document}アリストテレスは『形而上学』を次の一文で始める。\foreignlanguage{ancientgreek}{πάντες ἄνθρωποι τοῦ εἰδέναι ὀρέγονται φύσει.}ラテン語の伝統はこれを次のように伝えた。\foreignlanguage{latin}{omnes homines natura scire desiderant.}\end{document}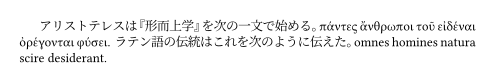
\foreignlanguage で箇所に印をつけても、文字の見た目は変わらない。その箇所が何語であるかを示し、その言語のハイフネーションの規則や慣習が適用されるようにするのである。このソースは pdfLaTeX ではコンパイルできない。fontspec(luatexja-fontspec はこれを土台にしている)は XeLaTeX か LuaLaTeX を必要とするからである。
ソースファイル、コンパイル、PDF
LaTeX の文書は、拡張子 .tex をもつプレーンテキストのファイルである。それは二つの部分からなる。プリアンブルは、ドキュメントクラスを宣言する 1 行目の \documentclass{article} から \begin{document} までである。ここで \usepackage によってパッケージを読み込み、形式に関する決定を定める。本文は \begin{document} から \end{document} までで、文章を収める。命令はバックスラッシュで始まり、命令が受け取るものは波括弧の中に書く。
このソースは完全な文書である。何も付け加えずにコンパイルでき、この講座の文書の出発点となる。
\documentclass{article}\usepackage{luatexja-fontspec}\setmainjfont{Noto Serif CJK JP}\begin{document}\section{はじめに}組版は、一文字ごとの置き場所を決める。\end{document}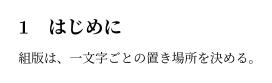
節には、書いていないのに番号 1 がつき、見出しには article クラスが定める書体と大きさが使われる。2 行目と 3 行目は日本語のための設定である。luatexja-fontspec パッケージは fontspec に日本語組版の機能を加え、\setmainjfont は和文を含む書体(ここでは Noto Serif CJK JP)を選ぶ。既定の書体(Latin Modern)には和文の文字が含まれないからである。実際の日本語文書では、ltjsarticle や jlreq のような日本語用のドキュメントクラスもよく使われる。
作業の流れは三段階からなる。ソースを書き、コンパイルし、結果を読む。コンパイルとは、ファイルに対してエンジンを実行することであり、この講座ではコマンド lualatex を使う。これはソースを読み、同じ名前の PDF ファイルを書き出す。そのそばには補助ファイルが残る。その一つが拡張子 .log のログファイルで、エンジンはそこにエラーと警告を記録する。もう一つは拡張子 .aux のファイルで、節やページの番号が保存される。そのため、目次や相互参照は二回目のコンパイルの後でなければ正しく現れない。一回目でエンジンはそれぞれのものがどこに置かれたかを記録し、二回目でそれを利用するのである。実際にはコマンドを手で入力することはなく、エディタがボタン一つで実行する。この講座では、自分のコンピュータで Texmaker を使うか、ブラウザで Overleaf を使う。その環境は次の回で整える。
ソースは書いたとおりに組まれるわけではなく、初めのうちの驚きのほとんどは三つの規則で説明できる。第一に、続けて書いた複数の空白は一つと同じであり、欧文では改行も空白一つとして扱われる。空きはエンジンが自分で配分するので、著者が書く空白は、そこで語が終わることを示すにすぎない。和文の文字どうしの間の改行は空白にならない。luatexja がこれを取り除くので、和文の段落はどこで改行してもよい。ただし和文の文字の間に書いた空白は、空白一つとして出力される。第二に、一つ以上の空行は段落を終え、新しい段落を始める。第三に、記号 % はコメントを始める。エンジンはそれ以降、行末までのすべてを、改行そのものも含めて無視する。
次のソースはわざと雑に書いてある。結果は空きの揃った二つの段落となり、コメント記号の後のメモは現れない。
連続した空白は 一つに まとめられ、行頭の空白は無視される。和文字の間の改行も空白にならない。空行は新しい段落を始める。% このメモは出力されない。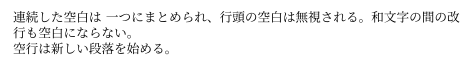
そうであるならば、パーセント記号を出力するには、それを書くだけでは足りない。前にバックスラッシュをつけて \% と書かなければならない。LaTeX が自分の働きのために予約している他の文字、たとえば波括弧やドル記号も同様である。
学術分野における LaTeX
数学、物理学、そして情報科学の大部分では、LaTeX が標準である。学術誌は独自のドキュメントクラスを提供し、著者はその書式で論文を投稿する。また、これらの分野の論文が出版前に公開されるリポジトリである arXiv は、LaTeX のソースを受け取り、自らコンパイルする。理由は数式の組版にある。これほど少ない手間でそれに並ぶシステムはほかになく、定理や数式の自動番号付けも備わっている。経済学、統計学、工学、化学でも広く使われている。
しかし、LaTeX を精密科学だけのものと考えるのは誤りである。哲学、古典文献学、歴史学では、その長所は別のところにあり、しかも劣らない。古典テキストに、写本の異読を行番号に結びつけた注として記録する校訂資料を添える校訂本のために、LaTeX には reledmac のような専用のパッケージがある。これは行に番号を振り、注を何層にも整理し、テキストが変わっても参照を保つ。多調ギリシア語やラテン語も、すでに見たように正しく書け、正しくハイフネーションされる。人文系の論文では数百にも及ぶ脚注が、自動的に番号を振られ、それぞれのページに配置される。そして参考文献は、BibLaTeX を使えばデータベースとして一度書くだけで、社会科学の著者年方式であれ、理系の番号方式であれ、人文系の脚注方式であれ、求められた様式で、オプション一つを変えるだけで引用できる。
LaTeX の限界
とはいえ、LaTeX には現実の代償があり、採用する前にそれを知っておくのがよい。学習曲線は急である。最初の数週間は、ワープロならクリック一つでできることのやり方を頻繁に調べる必要がある。TeX から受け継いだエラーメッセージはしばしば難解で、ときには誤りを含む行より後の行を指す。この単元の今後の回で、その読み方を学ぶ。ポスターや図版の多い雑誌のように、各要素を手で配置する自由なレイアウトのページは、DTP ソフトより手間がかかる。そして、受け取る側が皆それを受け入れるわけではない。少なからぬ人文系の学術誌、出版社、職場はワープロのファイルを求め、その変更履歴機能で校閲する。
そこから簡単な基準が導かれる。短い手紙、議事録、書式、あるいは他の人がワープロで手を入れる文章は、ワープロで書くほうがよい。構造、数式、引用、注、複数の言語をもつ長い文書、あるいは何年にもわたって修正と改訂を重ねる長い寿命をもつ文書は、LaTeX で書くほうがよい。
例題
次の問題は、述べたことを思い出すのではなく、それを応用することを求める。第一問はソースが何を出力するかを正確に予測すること、第二問は文書にどのエンジンとどの書体が必要かを判断すること、第三問は、その配慮なしに書かれたソースで内容を形式から切り離すことを求める。
コンパイルせずに、次の本文が出力する文章、段落の数、そしてそれぞれのパーセント記号がどうなるかを正確に予測せよ。
LaTeX では、組版が 一文字ごとの位置を決める。よい段落は目立たない。読者の 50 % は違いに気づかない。エンジン名 Lua%LaTeX は一語につながる。解答
最初の 3 行の間には空行がないので、一つの段落になる。LaTeX の後の連続した空白は一つになり、2 行目の行頭の空白は無視される。1 行目は和文字「が」で、2 行目は「。」で終わっているので、それらの改行は空白にならない。最初の段落は「LaTeX では、組版が一文字ごとの位置を決める。よい段落は目立たない。」となる。
続いて空行が二つある。段落を終えるには一つで足り、二つ目は何も加えない。空の段落も、大きな空きも生じない。したがって、ここで第二の段落が始まる。
読者の 50 % はの行では、パーセント記号は出力されない。それはコメントを始める。エンジンは「は」と改行を捨てる。残るのは記号の前に書いた空白だけで、次の行はそこから続く。「Lua」では、パーセント記号が欧文の語に直接ついている。改行を空白を残さずに捨て、エンジンは次の行の行頭の空白も読み飛ばす。したがって「Lua」と「LaTeX」は一つの語につながる。
第二の段落は「読者の 50 違いに気づかない。エンジン名 LuaLaTeX は一語につながる。」となる。著者は百分率を書こうとして文の一部を失ったが、エンジンは何のエラーも出していない。記号を出力するには
\%と書くべきであった。
哲学専攻の学生が、日本語で『パイドン』についての学位論文を書いている。その学生はプラトンの多調ギリシア語の原文やラテン語の注釈者の文章を引用し、大学は特定の書体の使用を求めている。その書体は OpenType ファイルとして学生のコンピュータにインストールされているが、ギリシア文字を含まない。必要なエンジンと、文書を欠けなく出力するためにさらに宣言すべきことを判断せよ。
解答
pdfLaTeX は、互いに独立した二つの理由で除外される。システムの OpenType 書体を直接読み込めないこと、そして特別なエンコーディングと書体を用意しなければ、Unicode で書いたギリシア文字がコンパイルを止めることである。大学指定の書体は必須なので、一つ目の理由だけで除外するに足りる。
XeLaTeX と LuaLaTeX は Unicode を読み、fontspec でシステムの書体を読み込む。どちらを使っても、大学指定の書体はプリアンブルで宣言できる。欧文書体は
\setmainfontで、和文書体は\setmainjfontで指定する。この講座では LuaLaTeX を使う。しかし、エンジンだけでは足りない。書体にギリシア文字がなければ、LuaLaTeX はエラーなしにコンパイルするが、ギリシア語の語は PDF に現れない。エンジンはそれをログファイルに
Missing characterのような警告として記録するだけである。問題はコンパイルの時点では見えず、結果を読んで初めてわかる。したがって、ギリシア語には、それを含む第二の書体を割り当てなければならない。babel を使い、
\babelprovide[import]{ancientgreek}で古典ギリシア語を言語として宣言し、\babelfont[ancientgreek]{rm}{GFS Didot}で書体を割り当てる。ギリシア語の箇所にはそれぞれ\foreignlanguageで印をつける。日本語の文書では、先の例のように、luatexja にギリシア文字を欧文文字として扱わせる設定も必要である。ラテン語はラテン文字で書かれ、大学指定の書体にはそれが含まれている。別の書体は必要なく、babel の
\babelprovide[import]{latin}で言語として宣言するだけでよい。そうすれば、その語は英語ではなくラテン語の規則でハイフネーションされる。まとめると、LuaLaTeX、主書体としての大学指定の書体、ギリシア語の箇所のための多調ギリシア文字を含む書体、そして言語として宣言した日本語、古典ギリシア語、ラテン語である。
ある著者が論文の第 2 節の冒頭をこのように書いた。内容ではなく形式を表している印を指摘し、それぞれのものが何であるかだけを述べるように書き直し、後で学術誌がギリシア語の用語をイタリックにしないよう求めた場合に何が得られるかを説明せよ。
{\Large\bfseries 2. 結果}\\[6pt]アリストテレスが \textit{Metaphysica} で述べるように、知を求める欲求は\textit{自然な}ものであり、ギリシア語の用語は \textit{φύσει} である。\\\vspace{12pt}{\large\bfseries 2.1. 標本}\\解答
1 行目は、実際には節の見出しであるものの大きさ、太さ、番号、間隔を手で決めている。これを
\section{結果}に置き換え、番号はクラスにつけさせる。手で書いた番号は、前に節が挿入されたとたんにずれてしまう。このソースでは
\textitが三回、三つの異なる役割で使われている。作品の題名、強調された語、ギリシア語の用語を示しているのである。三つとも今はイタリックで出力されるが、それは形式の偶然の一致であって、内容の同一性ではない。しかも和文にはイタリックが効かないので、「自然な」は実際には強調されて見えない。それぞれの役割に固有の印を与える。強調する語には
\emph{自然な}がある。残りの二つについては、プリアンブルで新しい命令を定義する。たとえば\newcommand{\sakuhin}[1]{\textit{#1}}と、同様の\yogoであり、本文では\sakuhin{Metaphysica}や\yogo{φύσει}のように使う。和文の強調の見せ方も、傍点やゴシック体などにプリアンブルで定めることができる。改行を強制する二重のバックスラッシュと、手で加えた垂直の空きは、段落間の区切りをまねている。これらは削除する。段落は空行で終え、間隔はクラスが決める。小節の見出しは
\subsection{標本}と書く。学術誌がギリシア語の用語をイタリックにしないよう求めた場合、プリアンブルの一行、つまり
\yogoを定義する行を変えるだけで、作品の題名や強調語には触れずに、論文中のすべての用語に変更が及ぶ。元のソースでは、イタリックを一つずつ確かめ、そのつどどの役割に当たるかを判断しなければならない。
オンライン演習
これらの演習では、入力欄にコードを書くと、ブラウザがすぐに点検する。コンパイルはせずに、波括弧、環境、各演習の求める内容を確かめる。点検を通ったら、コードを Texmaker に写してコンパイルするとよい。実際に何が出力されるかは、コンパイルした結果を見なければわからないからである。
入力欄には、スペイン語で書かれた文書の文章だけが入っている。点検はまさにこの文章を探すので、そのまま残すこと。これを LuaLaTeX でコンパイルできる完全な文書に仕上げよ。必要なのは、article クラス、fontspec と babel のパッケージ(言語は文章の言語であるスペイン語)、そして本文の始めと終わりである。スペイン語はラテン文字で書かれるので、和文書体は要らない。文章は変えない。
ブラウザーがコードをその場で確認します。コンパイルも採点もしません。実際の出力を見るには、Texmaker でコンパイルしてください。
ヒント
文書は二つの部分からなる。クラスで始まりパッケージを読み込むプリアンブルと、文章を収める本文である。
解答を見る
\documentclass{article}\usepackage{fontspec}\usepackage[spanish]{babel}\begin{document}\section{Introducción}La composición tipográfica decide dónde cae cada letra.\end{document}スペイン語の論文から取った次の断片は、各行が何であるかではなく、どう見えるべきかを述べている。内容に印をつけるように書き直せ。最初の見出しは節、二つ目は小節で、どちらもクラスが番号をつける。また「qué es」(「何であるか」)は強調される表現である。文章は変えない(点検はスペイン語の語を探す)。強制改行はなくなる。
ブラウザーがコードをその場で確認します。コンパイルも採点もしません。実際の出力を見るには、Texmaker でコンパイルしてください。
ヒント
各行について、それが何であるか(節の見出し、小節の見出し、強調される表現)を自問し、それを述べる命令を探すこと。それ以外はすべてクラスが決める。
解答を見る
\section{Marcado y procesador de textos}En un lenguaje de marcado, el autor dice \emph{qué es} cada cosa.\subsection{El procesador de textos}El autor ve la página tal como se imprimirá.演習問題
各問題にはヒントがあり、自分で取り組んでから開くとよい。また答えがあり、ヒントを開いた後に現れる。
次の本文がどんな文章を出力するかを予測せよ。ここで \LaTeX と \TeX は、LaTeX と TeX のロゴを出力する命令である。二つの行の違いを説明し、一行目の直し方を提案せよ。
\LaTeX Beamer でスライドを作る。\LaTeX{} Beamer と \TeX\ Live を毎日使う。ヒント
文字からなる命令の名前はどこで終わるか、そしてその直後の空白をエンジンがどう扱うかを考えよ。それは文章の一部か、命令の一部か。
答え
一つの段落になる。「LaTeXBeamer でスライドを作る。LaTeX Beamer と TeX Live を毎日使う。」命令の名前は文字でない最初の文字で終わり、その後に続く空白は命令を読む際に吸収される。二行目では、空の波括弧と、空白の前のバックスラッシュが命令を閉じ、空白を残す。一行目は \LaTeX{} Beamer とするか、空白の前にバックスラッシュを置けば直る。この例でわざと命令の後に欧文の語を置いたのは、和文が続く場合には luatexja が欧文と和文の間に自動で空きを入れるため、失われた空白が目に見えないからである。なお LuaLaTeX では漢字や仮名も文字とみなされるので、空白なしの \LaTeXで は別の、存在しない命令の名前になる。
次の各文書について、特別な準備なしにどのエンジンでコンパイルできるかを判断し、その理由を述べよ。LaTeX の既定の書体で組んだ英語の数学の学位論文。ラテン語の注のついたギリシア語の論考の校訂版で、システムにインストールされた OpenType 書体を使わなければならないもの。アラビア語とヒンディー語の文献を引用する日本語の論文。そのうえで、この講座がすべての文書に一つのエンジンを採用する理由を説明せよ。
ヒント
各文書について二つのことを自問せよ。システムの書体が必要か。ラテン文字以外の文字体系を含み、それを Unicode で読まなければならず、場合によっては文字を連結または結合させる必要があるか。
答え
数学の学位論文は三つのエンジンのどれでもよい。ギリシア語の校訂版は、システムの書体とギリシア語の Unicode のために、XeLaTeX か LuaLaTeX を必要とする。アラビア語とヒンディー語を含む日本語の論文も、Unicode、和文そのもの、連結・結合する文字、そしてアラビア語の右から左への書字のために、XeLaTeX か LuaLaTeX を必要とする。LuaLaTeX は三つすべてに使え、エンジンを一つにすれば講座のすべてのソースが同じ方法でコンパイルできる。
次の各場合について、LaTeX とワープロのどちらが適しているかを判断し、習慣以外の基準で理由を述べよ。役所に宛てた二ページの手紙。数式、番号付きの図、百五十の参考文献を含む二百ページの学位論文。ワープロのファイルしか受け付けず、変更履歴で校閲する歴史学の学術誌に投稿する論文。ギリシア語の引用を含み、著者が何年もかけて書き足していく講義ノート。
ヒント
それぞれの場合について、印刷された結果だけでなく、文書の長さと構造、どれだけ長く使われるか、そのファイルを他に誰が読んだり変更したりするかを考えよ。
答え
手紙はワープロで書く。短く、構造がなく、その後の寿命もない。学位論文は LaTeX で書く。その長さ、数式、相互参照は、自動番号付けとデータベースとしての参考文献の恩恵を受ける。論文はワープロで書く。受け取る側がそれを求めるからである。講義ノートは LaTeX で書く。長い寿命、成長していく構造、ギリシア語が、プレーンテキストと Unicode に有利に働く。