

 Español
 English
 Português
 中文 (中国)
 العربية
 हिन्दी
 Русский
 Français
 Ελληνικά
 Italiano
 日本語
 한국어
 Latine
Zusammenfassung
Diese Lektion zeigt, wie man die Sprachen eines Dokuments deklariert und seine Schriften wählt. Sie erklärt, was babel ändert, wenn man eine Sprache deklariert (die Silbentrennung, die Bezeichnungen, das Datum und die Anführungszeichen), und unterscheidet die drei Arten, die Sprache zu wechseln: \selectlanguage, \foreignlanguage und die Umgebung otherlanguage. Sie wendet das Gelernte auf das polytonische Griechisch und auf das Lateinische an, mit je einer Textstelle. Danach stellt sie fontspec vor: die drei Schriftfamilien eines Dokuments, \babelfont, um jeder Sprache eine Schrift zuzuweisen, und die nützlichsten OpenType-Eigenschaften (Mediävalziffern, Kapitälchen und Ligaturen). Sie zeigt, wie man prüft, ob eine Schrift alle Zeichen des Dokuments enthält, indem man die Warnungen „Missing character“ liest und mit albatross nach Schriften sucht, und erklärt, warum man die Schriften von TeX Live vorziehen sollte, wenn das Dokument auch in Overleaf kompilieren muss. Sie schließt mit einem kurzen Hinweis auf die Schriften, die von rechts nach links laufen, auf die ostasiatischen Schriften und auf polyglossia.
Lernziele
- Die Hauptsprache und die weiteren Sprachen eines Dokuments mit babel deklarieren und erklären, was jede Sprache im Ergebnis entscheidet.
- Zwischen
\foreignlanguage,otherlanguageund\selectlanguageje nachdem wählen, was sich ändern soll, und das Datum, die Bezeichnungen und die Anführungszeichen vorhersagen, die sich ergeben. - Textstellen in polytonischem Griechisch und in Latein mit ihrer Silbentrennung und einer geeigneten Schrift setzen.
- Schriften mit fontspec und babel zuweisen und Mediävalziffern, Kapitälchen und Ligaturen einschalten.
- Prüfen, ob die gewählten Schriften alle Zeichen und Schnitte enthalten, die das Dokument verwendet, und die Warnungen deuten, die das Gegenteil anzeigen.
- Zwischen einer Schrift aus TeX Live und einer Systemschrift danach entscheiden, wo das Dokument kompiliert werden muss.
Was sich mit der Sprache ändert
Die bisherigen Lektionen haben stets \usepackage[ngerman]{babel} geladen, ohne bei seiner Wirkung zu verweilen. Eine Sprache ist aber nicht bloß eine Liste von Buchstaben: Sie hat ihre Regeln, Wörter am Zeilenende zu trennen, ihre Namen für die Teile eines Dokuments, ihre Art, das Datum zu schreiben, und ihre Anführungszeichen. Das Paket babel fasst diese Konventionen nach Sprachen zusammen, und eine Sprache deklarieren heißt, babel zu bitten, sie anzuwenden. Im Einzelnen entscheidet die Sprache über:
- die Silbentrennung: mit welchen Mustern die Maschine die Stellen sucht, an denen ein Wort getrennt werden darf;
- die Bezeichnungen, die LaTeX von sich aus schreibt, wie die Überschrift des Inhaltsverzeichnisses oder den Namen der Tabellen und Abbildungen;
- das Datum, das
\todaydruckt, nämlich das des Kompilierens; - bestimmte Kürzel der Tastatur, wie die, die das Deutsche für die Anführungszeichen verwendet und die in diesem Abschnitt noch vorkommen.
Die drei Absätze verwenden dieselben Befehle; nur die Sprache, in der sie gelesen werden, ändert sich. \tablename, \figurename und \contentsname sind die Bezeichnungen der Tabellen, der Abbildungen und des Inhaltsverzeichnisses.
\documentclass{article}\usepackage{fontspec}\usepackage[latin, english, ngerman]{babel}\begin{document}Datum: \today. Bezeichnungen: \tablename, \figurename, \contentsname.\begin{otherlanguage}{english}Date: \today. Captions: \tablename, \figurename, \contentsname.\end{otherlanguage}\begin{otherlanguage}{latin}Dies: \today. Tituli: \tablename, \figurename, \contentsname.\end{otherlanguage}\end{document}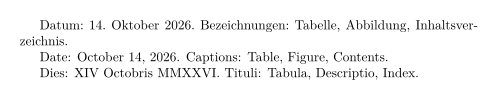
Das Lateinische schreibt Tag und Jahr in römischen Ziffern. Außerdem ist zu beachten, dass die Option ngerman der reformierten Rechtschreibung folgt; für Österreich gibt es naustrian, das im Datum „Jänner“ schreibt, und für die Schweiz nswissgerman.
Die Silbentrennung
Die Silbentrennung ist die am wenigsten sichtbare Wirkung der Sprache und die wichtigste. Jede Sprache trennt ihre Wörter nach ihrer eigenen Tradition: Das Deutsche trennt nach Sprechsilben und an den Fugen der Zusammensetzungen, das Englische achtet oft auf die Bildung des Wortes, wie in stand-ing, und das Lateinische bringt, je nach der Tradition, der seine Muster folgen, das s vor einem Konsonanten in die nächste Zeile. Wird eine Textstelle in einer anderen Sprache nicht ausgezeichnet, trennt die Maschine sie mit den Mustern der geltenden Sprache, und die Trennungen, die sie vorschlägt, können in jener Sprache falsch sein.
Der Befehl \showhyphens schreibt die Trennstellen, die die Maschine in den übergebenen Wörtern zulassen würde, in die Logdatei, ohne etwas im Dokument zu drucken. Damit lässt sich prüfen, welche Muster an welcher Stelle gelten.
Der Quelltext fragt nach den Trennstellen zweier englischer und zweier lateinischer Wörter, zuerst mit den Mustern des Deutschen, der Hauptsprache, und dann mit denen ihrer eigenen Sprache.
\documentclass{article}\usepackage{fontspec}\usepackage[latin, english, ngerman]{babel}\begin{document}\showhyphens{understanding knowledge}\foreignlanguage{english}{\showhyphens{understanding knowledge}}\showhyphens{nostrum conscientia}\foreignlanguage{latin}{\showhyphens{nostrum conscientia}}\end{document}Die Logdatei zeigt für jede Zeile eine Warnung über eine Box (harmlos: \showhyphens setzt die Wörter in eine sehr breite Zeile, um sie zu untersuchen) und darauf die Wörter mit ihren Trennstellen.
Underfull \hbox (badness 10000) in paragraph at lines 5--5[] \TU/lmr/m/n/10 un-der-stan-ding know-ledgeUnderfull \hbox (badness 10000) in paragraph at lines 6--6[] \TU/lmr/m/n/10 un-der-stand-ing knowl-edgeUnderfull \hbox (badness 10000) in paragraph at lines 7--7[] \TU/lmr/m/n/10 nos-trum con-sci-en-tiaUnderfull \hbox (badness 10000) in paragraph at lines 8--8[] \TU/lmr/m/n/10 no-strum con-scien-tiaMit den deutschen Mustern wird das Englische nach deutschen Sprechsilben getrennt, und eine Trennung wie know-ledge wäre in einem englischen Text ein sichtbarer Fehler; mit den englischen achten die Trennungen auf die Bildung der Wörter. Beim Lateinischen ist es ebenso: Zeile 7 trennt, wie man im Deutschen trennen würde, und Zeile 8 nach der Tradition der Muster von latin, die der italienischen Aussprache und Schulpraxis folgt. Deutschsprachige Textausgaben folgen meist der klassischen Trennung, die nos-trum trennt; babel stellt sie mit \babelprovide[hyphenrules=classiclatin]{latin} oder mit der Sprache classicallatin bereit.
Die deutschen Anführungszeichen
Der deutsche Satz kennt zwei Formen: die Anführungszeichen „…“, mit den halben ‚…‘ für ein Zitat im Zitat, und im Buchsatz die nach innen weisenden Guillemets »…«, mit ›…‹ im Inneren; in der Schweiz weisen sie nach außen, «…». Das deutsche babel definiert dafür Kürzel: "` öffnet und "' schließt die Anführungszeichen; "< und "> ergeben « und », sodass man »…« als ">…"< schreibt. Die halben Anführungszeichen setzen \glq und \grq, die einfachen Guillemets ›…‹ die Befehle \frq und \flq. Die Kürzel wechseln die Zeichen nicht nach der Ebene: Welches Zeichen innen steht, entscheidet der Autor.
"`Der Lehrer sagte: \glq wiederholt \emph{Anamnesis} laut\grq."'">Guillemets"< wie im Buchsatz, ``englische'' und `einfache' von Hand.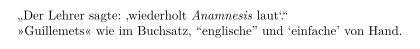
Die zweite Zeile zeigt nach den Guillemets die klassische Form von LaTeX, die nicht von der Sprache abhängt: Zwei Gravis-Akzente öffnen englische Anführungszeichen, und zwei Apostrophe schließen sie; je einer ergibt die einfachen. Im deutschen Text ist sie fehl am Platz, denn das englische öffnende Zeichen “ ist das deutsche schließende.
Davon zu unterscheiden ist ein Zufall. Die Schrift, die fontspec mit der Eigenschaft der TeX-Ligaturen lädt (davon weiter unten), wandelt zwei aufeinanderfolgende < von sich aus in ein Guillemet um, in jeder Sprache; das ist kein Kürzel von babel und wechselt die Zeichen nicht nach der Ebene: <<a <<b>> c>> ergibt im Deutschen «a «b» c», drei Paare ineinander. Nur das spanische babel macht aus diesen Zeichen Kürzel, die nach der Ebene wechseln: Dieselbe Zeile ergibt dort «a “b” c». Die Lektion über Fußnoten, Zitate und Verse behandelt die Zitate ausführlicher.
Inhalt wird geladen…
Abgeschlossen
Melde dich an, um deinen Fortschritt zu speichern