

 Español
 English
 Português
 中文 (中国)
 العربية
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 日本語
 한국어
 Latine
सारांश
यह पाठ सिखाता है कि किसी दस्तावेज़ की भाषाएँ कैसे घोषित की जाती हैं और उसके फ़ॉन्ट कैसे चुने जाते हैं। यह समझाता है कि babel में कोई भाषा घोषित करने से क्या बदलता है (शब्दों का विभाजन, अपने-आप लिखे जाने वाले नाम, तिथियाँ और अंक) और भाषा बदलने के तीन तरीक़ों में भेद करता है: \selectlanguage, \foreignlanguage और otherlanguage परिवेश। फिर इसे एक हिंदी पाठ पर लागू करता है जो बहुस्वरांकित प्राचीन यूनानी और लैटिन से उद्धरण देता है, दोनों का एक-एक अंश लेकर। इसके बाद fontspec का परिचय देता है: दस्तावेज़ के तीन फ़ॉन्ट परिवार, हर भाषा को फ़ॉन्ट सौंपने वाला \babelfont, और OpenType की वे विशेषताएँ जो देवनागरी और लैटिन लिपि में सबसे उपयोगी हैं (अंक, संयुक्ताक्षर और छोटे बड़े अक्षर)। यह सिखाता है कि कैसे जाँचें कि फ़ॉन्ट में दस्तावेज़ के सभी अक्षर हैं, “Missing character” चेतावनियाँ पढ़कर और albatross से फ़ॉन्ट खोजकर, और समझाता है कि जब दस्तावेज़ को Overleaf में भी संकलित होना हो तो TeX Live के फ़ॉन्ट क्यों बेहतर हैं। अंत में दाएँ से बाएँ लिखी जाने वाली लिपियों, पूर्वी एशियाई लिपियों और polyglossia का संक्षिप्त उल्लेख करता है।
अधिगम उद्देश्य
- babel से दस्तावेज़ की मुख्य और गौण भाषाएँ घोषित करना, और समझाना कि हर भाषा परिणाम में क्या तय करती है।
- जो बदलना है उसके अनुसार
\foreignlanguage,otherlanguageऔर\selectlanguageमें से चुनना, और परिणाम में आने वाली तिथि, नाम और उद्धरण चिह्नों का पूर्वानुमान करना। - बहुस्वरांकित प्राचीन यूनानी और लैटिन के अंशों को सही शब्द-विभाजन और उपयुक्त फ़ॉन्ट के साथ टाइपसेट करना।
- fontspec और babel से फ़ॉन्ट सौंपना, और अंकों, संयुक्ताक्षरों और छोटे बड़े अक्षरों का नियंत्रण करना।
- जाँचना कि चुने गए फ़ॉन्टों में दस्तावेज़ में प्रयुक्त सभी अक्षर और रूप हैं, और इसके विपरीत संकेत देने वाली चेतावनियों की व्याख्या करना।
- दस्तावेज़ को कहाँ संकलित होना है, इसके अनुसार TeX Live के फ़ॉन्ट और सिस्टम के फ़ॉन्ट में से चुनना।
भाषा के साथ क्या बदलता है
पिछले पाठों ने हर हिंदी दस्तावेज़ में \usepackage{babel}, \babelprovide[import,main]{hindi} और एक देवनागरी फ़ॉन्ट लोड किया, पर यह नहीं रुककर देखा कि ये पंक्तियाँ क्या करती हैं। भाषा केवल अक्षरों की सूची नहीं है: पंक्ति के अंत में शब्द तोड़ने के उसके अपने नियम हैं, दस्तावेज़ के हिस्सों के उसके अपने नाम, तिथि लिखने का उसका अपना ढंग और उसके अपने अंक। babel पैकेज इन परिपाटियों को भाषा के अनुसार इकट्ठा करता है, और किसी भाषा को घोषित करने का अर्थ है उससे इन्हें लागू करने को कहना। विशेष रूप से, भाषा तय करती है:
- शब्द-विभाजन: इंजन किन पैटर्नों से वे स्थान खोजता है जहाँ किसी शब्द को तोड़ा जा सकता है;
- वे नाम जो LaTeX अपने-आप लिखता है, जैसे विषय-सूची का शीर्षक या तालिकाओं और चित्रों का नाम;
- वह तिथि जो
\todayछापता है, यानी संकलन के दिन की तिथि; - अंक: हिंदी में अंतरराष्ट्रीय अंक (1, 2, 3) और देवनागरी अंक (१, २, ३) दोनों चलते हैं, और
\babelprovideके विकल्पmapdigitsके साथ babel टाइप किए गए अंकों को देवनागरी अंकों में छापता है।
तीनों अनुच्छेद वही आदेश इस्तेमाल करते हैं; केवल वह भाषा बदलती है जिसमें वे पढ़े जाते हैं। \tablename, \figurename और \contentsname तालिकाओं, चित्रों और विषय-सूची के नाम हैं।
\documentclass{article}\usepackage{fontspec}\usepackage[latin, english]{babel}\babelprovide[import,main]{hindi}\babelfont{rm}[Script=Devanagari]{IBM Plex Sans Devanagari}\begin{document}तिथि: \today{}। नाम: \tablename, \figurename, \contentsname{}।\begin{otherlanguage}{english}Date: \today. Captions: \tablename, \figurename, \contentsname.\end{otherlanguage}\begin{otherlanguage}{latin}Dies: \today. Tituli: \tablename, \figurename, \contentsname.\end{otherlanguage}\end{document}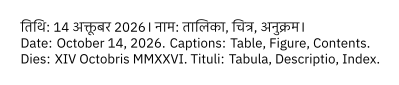
पंक्ति \babelfont{rm}[Script=Devanagari]{IBM Plex Sans Devanagari} एक देवनागरी फ़ॉन्ट चुनती है, जैसे इस पाठ्यक्रम के सभी हिंदी दस्तावेज़ों में; इसे फ़ॉन्टों वाले खंड में समझाया जाएगा। लैटिन दिन और वर्ष रोमन अंकों में लिखती है। यहाँ अंग्रेज़ी और लैटिन के अनुच्छेद भी इसी फ़ॉन्ट के लैटिन अक्षरों में छपते हैं, क्योंकि भाषा के बिना दिया गया \babelfont सभी भाषाओं पर लागू होता है।
शब्द-विभाजन
शब्द-विभाजन भाषा का सबसे कम दिखने वाला और सबसे महत्त्वपूर्ण प्रभाव है। हर भाषा अपने शब्दों को अपनी परंपरा के अनुसार तोड़ती है: babel हिंदी के लिए अपने पैटर्न देता है, अंग्रेज़ी अक्सर शब्द की बनावट का ध्यान रखती है, जैसे stand-ing में, और लैटिन, उस परंपरा के अनुसार जिसका उसके पैटर्न पालन करते हैं, व्यंजन से पहले आने वाले s को अगली पंक्ति में ले जाती है। यदि किसी दूसरी भाषा के अंश को चिह्नित न किया जाए, तो इंजन उसे चालू भाषा के पैटर्नों से तोड़ता है, और जो स्थान वह सुझाता है वे उस भाषा में ग़लत हो सकते हैं या होते ही नहीं।
आदेश \showhyphens उन शब्दों में, जो उसे मिलते हैं, इंजन द्वारा स्वीकार्य विभाजन-स्थान लॉग में लिखता है, और दस्तावेज़ में कुछ नहीं छापता। इससे यह जाँचा जा सकता है कि हर जगह कौन-से पैटर्न लागू हैं।
स्रोत दो अंग्रेज़ी और दो लैटिन शब्दों के विभाजन-स्थान माँगता है, पहले मुख्य भाषा हिंदी के पैटर्नों से और फिर उनकी अपनी भाषा के पैटर्नों से।
\documentclass{article}\usepackage{fontspec}\usepackage[latin, english]{babel}\babelprovide[import,main]{hindi}\begin{document}\showhyphens{understanding knowledge}\foreignlanguage{english}{\showhyphens{understanding knowledge}}\showhyphens{nostrum conscientia}\foreignlanguage{latin}{\showhyphens{nostrum conscientia}}\end{document}लॉग हर पंक्ति के लिए पहले एक बॉक्स-संबंधी चेतावनी देता है (हानिरहित: \showhyphens शब्दों को जाँचने के लिए उन्हें बहुत चौड़ी पंक्ति में रखता है), और फिर विभाजन-स्थानों सहित शब्द।
Underfull \hbox (badness 10000) in paragraph at lines 6--6[] \TU/lmr/m/n/10 understanding knowledgeUnderfull \hbox (badness 10000) in paragraph at lines 7--7[] \TU/lmr/m/n/10 un-der-stand-ing knowl-edgeUnderfull \hbox (badness 10000) in paragraph at lines 8--8[] \TU/lmr/m/n/10 nostrum conscientiaUnderfull \hbox (badness 10000) in paragraph at lines 9--9[] \TU/lmr/m/n/10 no-strum con-scien-tiaहिंदी के पैटर्न केवल देवनागरी अक्षरों को जानते हैं, इसलिए पंक्ति 6 और 8 में अंग्रेज़ी और लैटिन शब्दों को एक भी विभाजन-स्थान नहीं मिलता: पंक्ति के अंत में आया लंबा अचिह्नित शब्द नहीं टूटेगा, और पंक्ति हाशिये में निकल जाएगी या फैल जाएगी। अंग्रेज़ी के पैटर्नों से विभाजन शब्दों की बनावट का ध्यान रखता है, और लैटिन के पैटर्नों से (पंक्ति 9) लैटिन परंपरा का पालन करता है।
हिंदी के उद्धरण चिह्न
हिंदी में उद्धरण के पहले स्तर पर दोहरे उद्धरण चिह्न “” लगते हैं, और उनके भीतर इकहरे ‘’। हिंदी का babel उद्धरण चिह्नों के लिए कोई संक्षिप्त रूप परिभाषित नहीं करता, न ही स्तर के अनुसार उन्हें बदलता है, और csquotes में हिंदी की कोई शैली नहीं है: कौन-से चिह्न लगें, यह लेखक तय करता है। LuaLaTeX में उन्हें सीधे कीबोर्ड से लिखा जा सकता है, जैसा उदाहरण में है।
“गुरु ने कहा: ‘ज़ोर से दोहराओ।’”``अंग्रेज़ी उद्धरण चिह्न'' और `इकहरे', हाथ से लिखे हुए।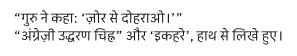
दूसरी पंक्ति LaTeX का पारंपरिक तरीक़ा दिखाती है, जो भाषा पर निर्भर नहीं: दो उलटे एपॉस्ट्रॉफ़ी (backtick) अंग्रेज़ी उद्धरण खोलते हैं और दो एपॉस्ट्रॉफ़ी उन्हें बंद करते हैं; हर एक का एक-एक इकहरे चिह्न देता है।
फिर भी संक्षिप्त रूप और संयोग में भेद करना चाहिए। fontspec द्वारा TeX संयुक्ताक्षर विशेषता के साथ लोड किया गया फ़ॉन्ट, जिसे आगे देखेंगे, किसी भी भाषा में दो लगातार < चिह्नों को अपने-आप कोणीय उद्धरण चिह्न « में बदल देता है। स्पैनिश और फ़्रेंच के दस्तावेज़ यही चिह्न लगाते हैं; हिंदी के उद्धरण चिह्न सीधे लिखने चाहिए। पाद-टिप्पणियों, उद्धरणों और पद्यों वाला पाठ उद्धरणों को और विस्तार से देखेगा।
सामग्री लोड हो रही है…