

 Español
 English
 Português
 中文 (中国)
 العربية
 हिन्दी
 Русский
 Français
 Deutsch
 Ελληνικά
 Italiano
 한국어
 Latine
要約
この課では、文書の言語を宣言し、そのフォントを選ぶ方法を学ぶ。babel で言語を宣言すると何が変わるか(ハイフネーション、自動で入る名称、日付、引用符)を説明し、言語を切り替える三つの方法、\selectlanguage、\foreignlanguage、otherlanguage 環境を区別する。それを、多調音古典ギリシア語とラテン語を引用する日本語の文章に当てはめ、それぞれ一節ずつ例に取り、luatexja ではギリシア文字に追加の設定が要る理由も説明する。続いて fontspec を紹介する。文書の三つのフォントファミリー、言語ごとにフォントを割り当てる \babelfont、学術文書で最も役に立つ OpenType の機能(オールドスタイル数字、スモールキャピタル、合字)であり、和文フォントと欧文フォントの役割分担もあわせて説明する。さらに、フォントが文書のすべての文字を含んでいるかを、警告「Missing character」を読み、albatross でフォントを探すことで確かめる方法を学び、文書を Overleaf でもコンパイルする必要があるとき TeX Live のフォントを優先すべき理由を説明する。最後に、右から左へ書く文字、中国語・日本語・韓国語の組版パッケージ、polyglossia に簡単に触れる。
学習目標
- babel で文書の主言語と副言語を宣言し、各言語が組版結果の何を決めるかを説明する。
- 変えるべきものに応じて
\foreignlanguage、otherlanguage、\selectlanguageを使い分け、結果として得られる日付・名称・引用符を予測する。 - 多調音古典ギリシア語とラテン語の文章を、正しいハイフネーションと適切なフォントで組む。
- fontspec と babel でフォントを割り当て、オールドスタイル数字、スモールキャピタル、合字を有効にする。
- 選んだフォントが文書の使うすべての文字と字形を含んでいるかを確かめ、そうでないことを示す警告を読み解く。
- 文書をどこでコンパイルする必要があるかに応じて、TeX Live のフォントとシステムのフォントのどちらを使うかを決める。
言語によって変わるもの
これまでの課の日本語文書は luatexja-fontspec を読み込み、自動で入る名称が必要なときには \usepackage{babel} と \babelprovide[import,main]{japanese} も読み込んできたが、それらが何をするかには立ち入らなかった。言語は文字の一覧にとどまらない。行末で単語を分ける独自の規則、文書の各部分の呼び名、日付の書き方、そして独自の引用符がある。babel パッケージはこうした約束事を言語ごとにまとめており、言語を宣言するとは、それらを適用するよう babel に頼むことである。日本語そのものの組版規則(和文文字間の改行、禁則処理、約物の詰め、和欧文間の空白)は luatexja が受け持つ。この仕事を二つのパッケージが同時に行うことはできない。\babelprovide[import,main]{japanese} は babel 独自の和文の行分割処理も有効にし、これが luatexja の処理と重なって、読点、句点、かぎ括弧、丸括弧を何の知らせもなく半角幅に詰めてしまう。そのため本講座の文書では、その後に \babeladjust{linebreak.cjk=off} と書き、和文組版を luatexja にすべて任せる。具体的には、言語が決めるのは次のものである。
- ハイフネーション:エンジンが単語を分けてよい位置をどのパターンで探すか。
- LaTeX が自分で書き込む名称:目次の見出しや、表と図の名前など。
\todayが出力する日付:コンパイルした日の日付。- 言語によってはキーボード入力の略記:たとえばスペイン語が引用符のために定めているもの。日本語にはこの種の略記はなく、日本語の括弧の入力については本節で後述する。
三つの段落は同じ命令を使っている。変わるのは、それを読む言語だけである。\tablename、\figurename、\contentsname は、表、図、目次の名称である。
\documentclass{article}\usepackage{luatexja-fontspec}\setmainjfont{Noto Serif CJK JP}\usepackage[latin, english]{babel}\babelprovide[import,main]{japanese}\babeladjust{linebreak.cjk=off}\begin{document}日付:\today{}。名称:\tablename{}、\figurename{}、\contentsname{}。\begin{otherlanguage}{english}Date: \today. Captions: \tablename, \figurename, \contentsname.\end{otherlanguage}\begin{otherlanguage}{latin}Dies: \today. Tituli: \tablename, \figurename, \contentsname.\end{otherlanguage}\end{document}
日本語の行では各命令の後に {} を書いている。LuaLaTeX では仮名や漢字も文字(letter)なので、命令名の直後に続く和文文字は命令名の一部として読まれてしまうからである。ラテン語は日と年をローマ数字で書く。日本語の日付で数字と漢字のあいだに入る小さな空白は、luatexja が自動で入れる和欧文間空白である。
ハイフネーション
ハイフネーションは、言語がもたらす効果のうち最も目立たず、しかも最も重要なものである。日本語自体はハイフネーションをしない。luatexja は任意の和文文字のあいだで改行を許し、禁則(句点を行頭に置かないなど)だけを守る。しかし日本語の文章には欧文の単語がよく混じり、欧文の各言語はそれぞれの伝統に従って単語を分ける。英語はしばしば語の成り立ちを尊重し(stand-ing)、ラテン語は、そのパターンが従う伝統により、子音が続く s を次の行へ送る。他の言語の一節に印を付けなければ、エンジンはそれを現在の言語のパターンで分け、提案される分割位置はその言語にとって誤りになりうる。
命令 \showhyphens は、与えられた単語でエンジンが認める分割位置をログに書き出し、文書には何も出力しない。どこでどのパターンが働いているかを確かめるのに役立つ。
次のソースは、英語の二語とラテン語の二語の分割位置を、まず主言語である日本語のパターンで、次にそれぞれの言語のパターンで求める。文書に和文文字がないので、ここでは luatexja は要らない。
\documentclass{article}\usepackage{fontspec}\usepackage[latin, english]{babel}\babelprovide[import,main]{japanese}\begin{document}\showhyphens{understanding knowledge}\foreignlanguage{english}{\showhyphens{understanding knowledge}}\showhyphens{nostrum conscientia}\foreignlanguage{latin}{\showhyphens{nostrum conscientia}}\end{document}ログには各行について、まずボックスについての警告(無害である。\showhyphens は単語を調べるために非常に広い行に組む)が出て、続いて分割位置の入った単語が出る。
Underfull \hbox (badness 10000) in paragraph at lines 6--6[] \TU/lmr/m/n/10 un-der-stand-ing knowl-edgeUnderfull \hbox (badness 10000) in paragraph at lines 7--7[] \TU/lmr/m/n/10 un-der-stand-ing knowl-edgeUnderfull \hbox (badness 10000) in paragraph at lines 8--8[] \TU/lmr/m/n/10 nos-trum con-sci-en-tiaUnderfull \hbox (badness 10000) in paragraph at lines 9--9[] \TU/lmr/m/n/10 no-strum con-scien-tiababel の日本語には独自のハイフネーションパターンがなく、欧文の単語には英語のパターンを使う。ログにもその旨の情報「Hyphen rules for 'japanese' set to \l@english」が出る。そのため 6 行目と 7 行目はまったく同じになる。ラテン語は違う。8 行目は英語流に con-sci-en-tia と分け、9 行目はラテン語の伝統どおり no-strum con-scien-tia と分ける。日本語の文章に引くラテン語、フランス語、ドイツ語の一節には、印を付ける必要がある。
日本語の括弧
日本語では、引用の第一段にかぎ括弧「」を、その内側に二重かぎ括弧『』を用いる。babel の日本語は括弧のための略記を定めておらず、段に応じて括弧を替えることもしない。どれを使うかは書き手が決める。LuaLaTeX ではキーボードから直接入力でき、次の例のとおりである。
「先生は『声に出して繰り返しなさい』と言った。」``英語の引用符''と`一重の引用符'を手で入力する。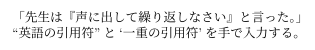
二行目は、言語によらない LaTeX の古典的な書き方を示す。バッククォート二つが英語の引用符を開き、アポストロフィ二つが閉じる。一つずつにすると一重の引用符になる。これらはバッククォートとアポストロフィが ASCII 文字なので欧文フォントで組まれる。
ただし、略記と偶然の一致とは区別しなければならない。fontspec が欧文フォントを読み込むときに既定で有効にする TeX の合字機能(後述)は、連続する二つの < を、どの言語でもギユメ«に変える。スペイン語やフランス語の文書が使うのはこの引用符だが、日本語の括弧は直接入力すべきである。引用については脚注・引用・韻文の課でさらに詳しく扱う。
コンテンツを読み込んでいます…